Il tuo sito è leggibile per le AI? La checklist tecnica per scoprirlo
 Di Nicola Burei
(aggiornato il )
Indice dei contenuti

Prima di chiederti perché ChatGPT o Perplexity non citano il tuo sito, c’è una domanda più basilare: riescono a leggerlo? Una parte dei siti che analizzo ha problemi di leggibilità tecnica che escludono i contenuti dai motori generativi prima di qualsiasi valutazione di qualità. E non capita solo ai siti trascurati: uno studio ha rilevato che, tra i 100 principali siti di news americani e britannici, il 71% blocca almeno uno dei bot che portano le pagine dentro le risposte AI, spesso nella convinzione di bloccare solo l’addestramento dei modelli1. In questo articolo trovi la checklist che seguo nell’audit di leggibilità AI dei miei clienti: cosa verifico, con quali criteri, e quali allarmi sono falsi.
Perché la leggibilità tecnica è diversa da quella per Google
Googlebot esegue JavaScript: se il tuo sito costruisce i contenuti nel browser, prima o poi Google li vede comunque. La maggior parte dei crawler AI no. La misurazione più solida disponibile, condotta da MERJ e Vercel sul traffico della rete Vercel, dice che nessun crawler di OpenAI, Anthropic, Meta, ByteDance o Perplexity esegue JavaScript; lo fanno solo Gemini, che usa l’infrastruttura di Googlebot, e Applebot2. Il dettaglio rivelatore: GPTBot scarica i file JavaScript (l’11,5% delle sue richieste), ma non li esegue mai. Se un contenuto compare solo dopo il rendering, per GPTBot, ClaudeBot o PerplexityBot quella pagina è in gran parte vuota.
Lo stesso studio mostra crawler ancora immaturi: circa il 35% delle richieste di ChatGPT e Claude finiva su pagine 404, contro l’8% di Googlebot2. Un crawler che sbaglia più di un URL su tre non recupera da solo la pagina giusta: la trova solo se gliela indichi tu, con URL stabili, sitemap aggiornata e link interni coerenti.
Tre famiglie di bot, tre conseguenze diverse

Il primo errore da evitare è trattare “i bot AI” come una categoria unica. Le piattaforme dichiarano tre famiglie con scopi diversi3, e bloccare l’una o l’altra ha conseguenze opposte:
| Famiglia | Cosa fa | Esempi | Se la blocchi |
|---|---|---|---|
| Training | Raccoglie contenuti per addestrare i modelli futuri | GPTBot, ClaudeBot, Google-Extended, CCBot | Scelta legittima di tutela; il brand entra meno nella conoscenza “a memoria” dei modelli che verranno |
| Search | Indicizza le pagine per la ricerca dei motori AI | OAI-SearchBot, Claude-SearchBot, PerplexityBot | Il sito esce dalle fonti che le risposte possono citare |
| Fetcher su richiesta | Apre una pagina quando un utente la chiede in chat | ChatGPT-User, Perplexity-User, Claude-User | La pagina non è leggibile proprio nel momento in cui una risposta la vorrebbe usare |
Tre precisazioni facili da trascurare quando si mette mano al robots.txt:
- Google-Extended non è un crawler: non è un bot che visita il sito, ma un permesso d’uso che scrivi nel robots.txt. A scaricare le pagine è sempre Googlebot; Google-Extended dice solo se Google può usare quei contenuti per l’addestramento e il grounding di Gemini. Per questo bloccarlo non ti toglie (né ti tiene fuori) dalle AI Overviews, che dipendono da Googlebot come tutta la ricerca Google4. Per escludersi dalle funzioni AI di Google restando nei risultati classici c’è ora un controllo dedicato in Search Console, descritto al punto 9 della checklist.
- I fetcher su richiesta non sempre rispettano il robots.txt: la documentazione di Perplexity dichiara che Perplexity-User “generalmente lo ignora”, OpenAI scrive che per ChatGPT-User le regole “potrebbero non applicarsi”, Anthropic invece dichiara che Claude-User lo rispetta3.
- I volumi sono sbilanciati sul training: nel 2025 circa l’80% del traffico dei crawler AI dichiarava scopo di addestramento, ma la parte che cresce più in fretta è quella dei fetcher su richiesta, più che ventuplicata nel corso dell’anno secondo Cloudflare5.
La conseguenza pratica: bloccare il training è una decisione di policy che si può difendere; bloccare search e fetcher mentre si vorrebbe comparire nelle risposte AI è un autogol. Nel mio audit i due casi hanno esiti diversi: il blocco dei bot di search e dei fetcher è una criticità, quello dei bot di training una segnalazione.
La checklist
1. robots.txt: chi stai bloccando, e lo sai?
Molti blocchi non sono decisioni: sono righe copiate da un template, o scelte fatte anni fa per proteggersi dallo scraping e mai riviste. Cerca nel robots.txt gli user agent delle tre famiglie e chiediti, per ognuno, se il blocco è voluto e se colpisce la famiglia giusta. I numeri dicono che la confusione è la norma. Il monitoraggio continuo di Palewire conta, a luglio 2026, GPTBot bloccato da metà delle 1.156 testate giornalistiche osservate1. Fin qui è comprensibile: GPTBot serve all’addestramento, e bloccarlo (a mio avviso) difende legittimamente i propri contenuti. L’errore strategico arriva dopo: lo studio citato in apertura mostra che i blocchi colpiscono in maggioranza anche i bot di search, cioè proprio quelli che porterebbero le citazioni. Bloccarli non protegge nulla, toglie solo visibilità.
2. La CDN può bloccare anche quello che il robots.txt permette
A volte il problema non è nel robots.txt, ma nel server che ospita il sito. Il robots.txt è una dichiarazione di intenti; quello che conta è come il server risponde davvero quando un bot chiede una pagina.
Ad esempio, da luglio 2025 Cloudflare, che gestisce circa un quinto del traffico web, blocca di default tutti i crawler AI su ogni nuovo dominio inserito nella piattaforma, bot di search e fetcher compresi. Attenzione però: default non significa irrevocabile. È un’impostazione che si può cambiare dal pannello di controllo in pochi minuti; il problema non è quindi la serratura, è non sapere di averla chiusa.
NOTA: Cloudflare ha annunciato che apporterà un correttivo a questo comportamento a partire dal 15 settembre 2026: il default per i nuovi domini distinguerà per scopo, con i bot di search permessi, mentre gli altri bot come quelli di training saranno bloccati sulle pagine con pubblicità5 (impostazione sempre modificabile).
Il risultato sono siti convinti di essere aperti che rispondono 403 o servono una challenge JavaScript ai bot AI, senza che nessuno l’abbia mai deciso.
3. I contenuti devono stare nell’HTML servito

Il test più semplice resta il migliore: apri una pagina importante, disattiva JavaScript nel browser e ricaricala. Quello che vedi è ciò che vede la maggior parte dei crawler AI. In alternativa apri il sorgente della pagina (“Visualizza sorgente” nel browser: è l’HTML così come il server lo consegna) e cerca con Ctrl+F due o tre frasi chiave del contenuto: se non ci sono, c’è un problema di rendering. Chi ha dimestichezza col terminale ottiene lo stesso con curl. Nei miei audit è uno dei controlli che eseguo su ogni pagina importante.
4. Tempi di risposta: conta l’affidabilità, non il record
Su questo punto conviene essere onesti: nessuna piattaforma dichiara un timeout ufficiale per i propri bot, e le soglie “1-5 secondi” che circolano nei blog GEO non hanno una fonte primaria. I punti fermi sono altri due. Google documenta che la velocità del server muove direttamente quanto Googlebot scarica: risposte rapide alzano il limite di crawl, rallentamenti ed errori lo abbassano6. E sui motori AI esiste un dato indiretto ma pesante: su circa 700.000 pagine analizzate, quelle in cui i fetch falliscono più di 3 volte su 4 raccolgono circa 18 volte meno citazioni dai sistemi di OpenAI rispetto alle pagine che rispondono in modo affidabile7. Un TTFB sotto 0,8 secondi resta un buon riferimento (è la soglia “buona” di Google, pensata per gli utenti, non per i bot)6; CDN e caching sono i primi alleati, purché configurati per non respingere proprio i bot che vuoi accogliere (punto 2).
5. Dati strutturati: chiarezza dell’entità, non scorciatoia per le citazioni
Qui l’evidenza è genuinamente contrastante, e vale la pena riportarla com’è. Google scrive che per comparire nelle sue funzioni AI non serve nessun markup speciale; Bing sostiene che lo schema aiuta i suoi modelli a capire i contenuti8. A raffreddare gli entusiasmi arrivano i due studi più rigorosi. Ahrefs ha seguito 1.885 pagine che avevano aggiunto JSON-LD e le ha confrontate con un gruppo di controllo: le citazioni AI sono rimaste ferme, con un piccolo calo sulle AI Overviews8. Uno studio indipendente su oltre mille pagine conferma il risultato per lo schema generico, e aggiunge due dettagli utili. Il primo è che il predittore dominante delle citazioni resta la posizione organica su Google. Il secondo è che l’unica eccezione a favore del markup sono i tipi con dati concreti, come Product e Review con prezzi e valutazioni, e pesa soprattutto sui siti con poca authority8. La sintesi più onesta è di John Mueller (Google): il markup aiuta per i dati che una macchina non può ricavare in modo affidabile dal testo, come prezzi e disponibilità; sul resto, dice, “c’è molto wishful thinking”8.
La mia linea negli audit segue questa evidenza: i dati strutturati si curano per la chiarezza dell’entità, senza aspettarsi citazioni in cambio del markup. Nell’ordine: un blocco Organization completo (name, address, sameAs, e foundingDate se l’anzianità è un pregio), che è la scheda aziendale machine-readable con cui smentisci alla fonte gli errori dei motori su identità e sede; Article con date reali sui contenuti; FAQPage dove esistono domande e risposte vere; i tipi del tuo settore (Course per la formazione, Product per l’e-commerce, Service per i servizi), che abilitano i rich results di categoria. E la regola sempre valida: il JSON-LD deve dire le stesse cose del testo visibile.
6. llms.txt: adozione in crescita, lettura quasi nulla
È la voce più controintuitiva della checklist, perché adozione e utilità viaggiano in direzioni opposte. Da un lato l’adozione cresce: i siti con un llms.txt sono aumentati di quasi nove volte in un anno, complice Shopify, che ha iniziato a generarlo in automatico9. Dall’altro, chi dovrebbe leggerlo non lo legge: un’analisi di Ahrefs sui log di 137.000 domini ha trovato che il 97% dei file llms.txt non ha ricevuto nemmeno una richiesta in un mese, e le richieste che arrivano vengono più spesso da tool di audit SEO che dai motori9. John Mueller è stato netto: “nessun sistema AI oggi usa llms.txt”, paragonandolo al meta tag keywords, un’autodichiarazione del sito che nessun motore verifica, e che perciò non conta9.
L’unico ecosistema in cui il file viene letto sono gli agenti di sviluppo: nei log di Ahrefs il secondo bot AI per richieste è Claude Code.
Da qui la mia posizione: costo quasi zero, va bene farlo, ma in fondo alla lista, e non deve spostare nessuna decisione. Ho approfondito da dove nasce il file e perché oggi lo considero lo strumento più sovrastimato del discorso GEO in un articolo dedicato.
7. Sitemap sincera e date visibili
La sitemap ha un campo, lastmod, con cui dichiara ai motori quando ogni pagina è stata aggiornata l’ultima volta. Il problema è che quella data spesso mente senza volerlo: una migrazione, un cambio di template o un deploy che riscrive tutti i file aggiorna il lastmod dell’intero sito in un giorno solo, anche se nessun contenuto è cambiato. Per questo nel mio audit confronto la data dichiarata con le date che si leggono nelle pagine: se la sitemap dice “aggiornato ieri” ma il contenuto più recente mostra una data di tre anni fa, la freshness è solo dichiarata. E i motori generativi alla freshness sono sensibili: Ahrefs ha misurato su quasi 17 milioni di citazioni che gli assistenti AI citano contenuti in media più recenti del 25,7% rispetto ai risultati organici di Google, con ChatGPT il più orientato al nuovo10; un’analisi su oltre 5.000 URL citati trova che circa due terzi puntano a contenuti pubblicati o aggiornati nell’ultimo anno10.
La conseguenza pratica: date visibili sulle pagine (pubblicazione e aggiornamento), aggiornamenti veri sui contenuti importanti, e un lastmod che dice la verità.
8. Semantica di base: un H1, gerarchia pulita, niente residui
I controlli meno appariscenti, e tra quelli che i siti sbagliano più spesso: un solo H1 per pagina, allineato all’intento; gerarchia degli heading senza salti (da H2 a H4 senza passare per H3: per un modello che usa la struttura per capire il documento è disordine); title e attributo lang presenti; canonical coerente, perché versioni multiple della stessa pagina (con e senza www, con parametri, in http e https) diluiscono i segnali; e nessun noindex dimenticato su pagine importanti: il classico residuo di un ambiente di staging, raro, ma quando c’è azzera tutto il resto.
9. Anteprime e snippet: il permesso che nessuno ricontrolla
Per comparire come fonte in un’AI Overview una pagina deve essere idonea a essere mostrata con uno snippet: è un requisito che Google dichiara esplicitamente per le sue funzioni AI4. Le direttive che governano le anteprime (nosnippet, data-nosnippet, max-snippet) valgono quindi anche lì: chi le ha impostate in modo restrittivo, magari anni fa per prudenza verso gli aggregatori, oggi si sta escludendo dalle AI Overviews senza saperlo. Il controllo è rapido: cercare quelle direttive nei meta robots e nell’HTML delle pagine importanti, e chiedersi se sono ancora una scelta voluta.
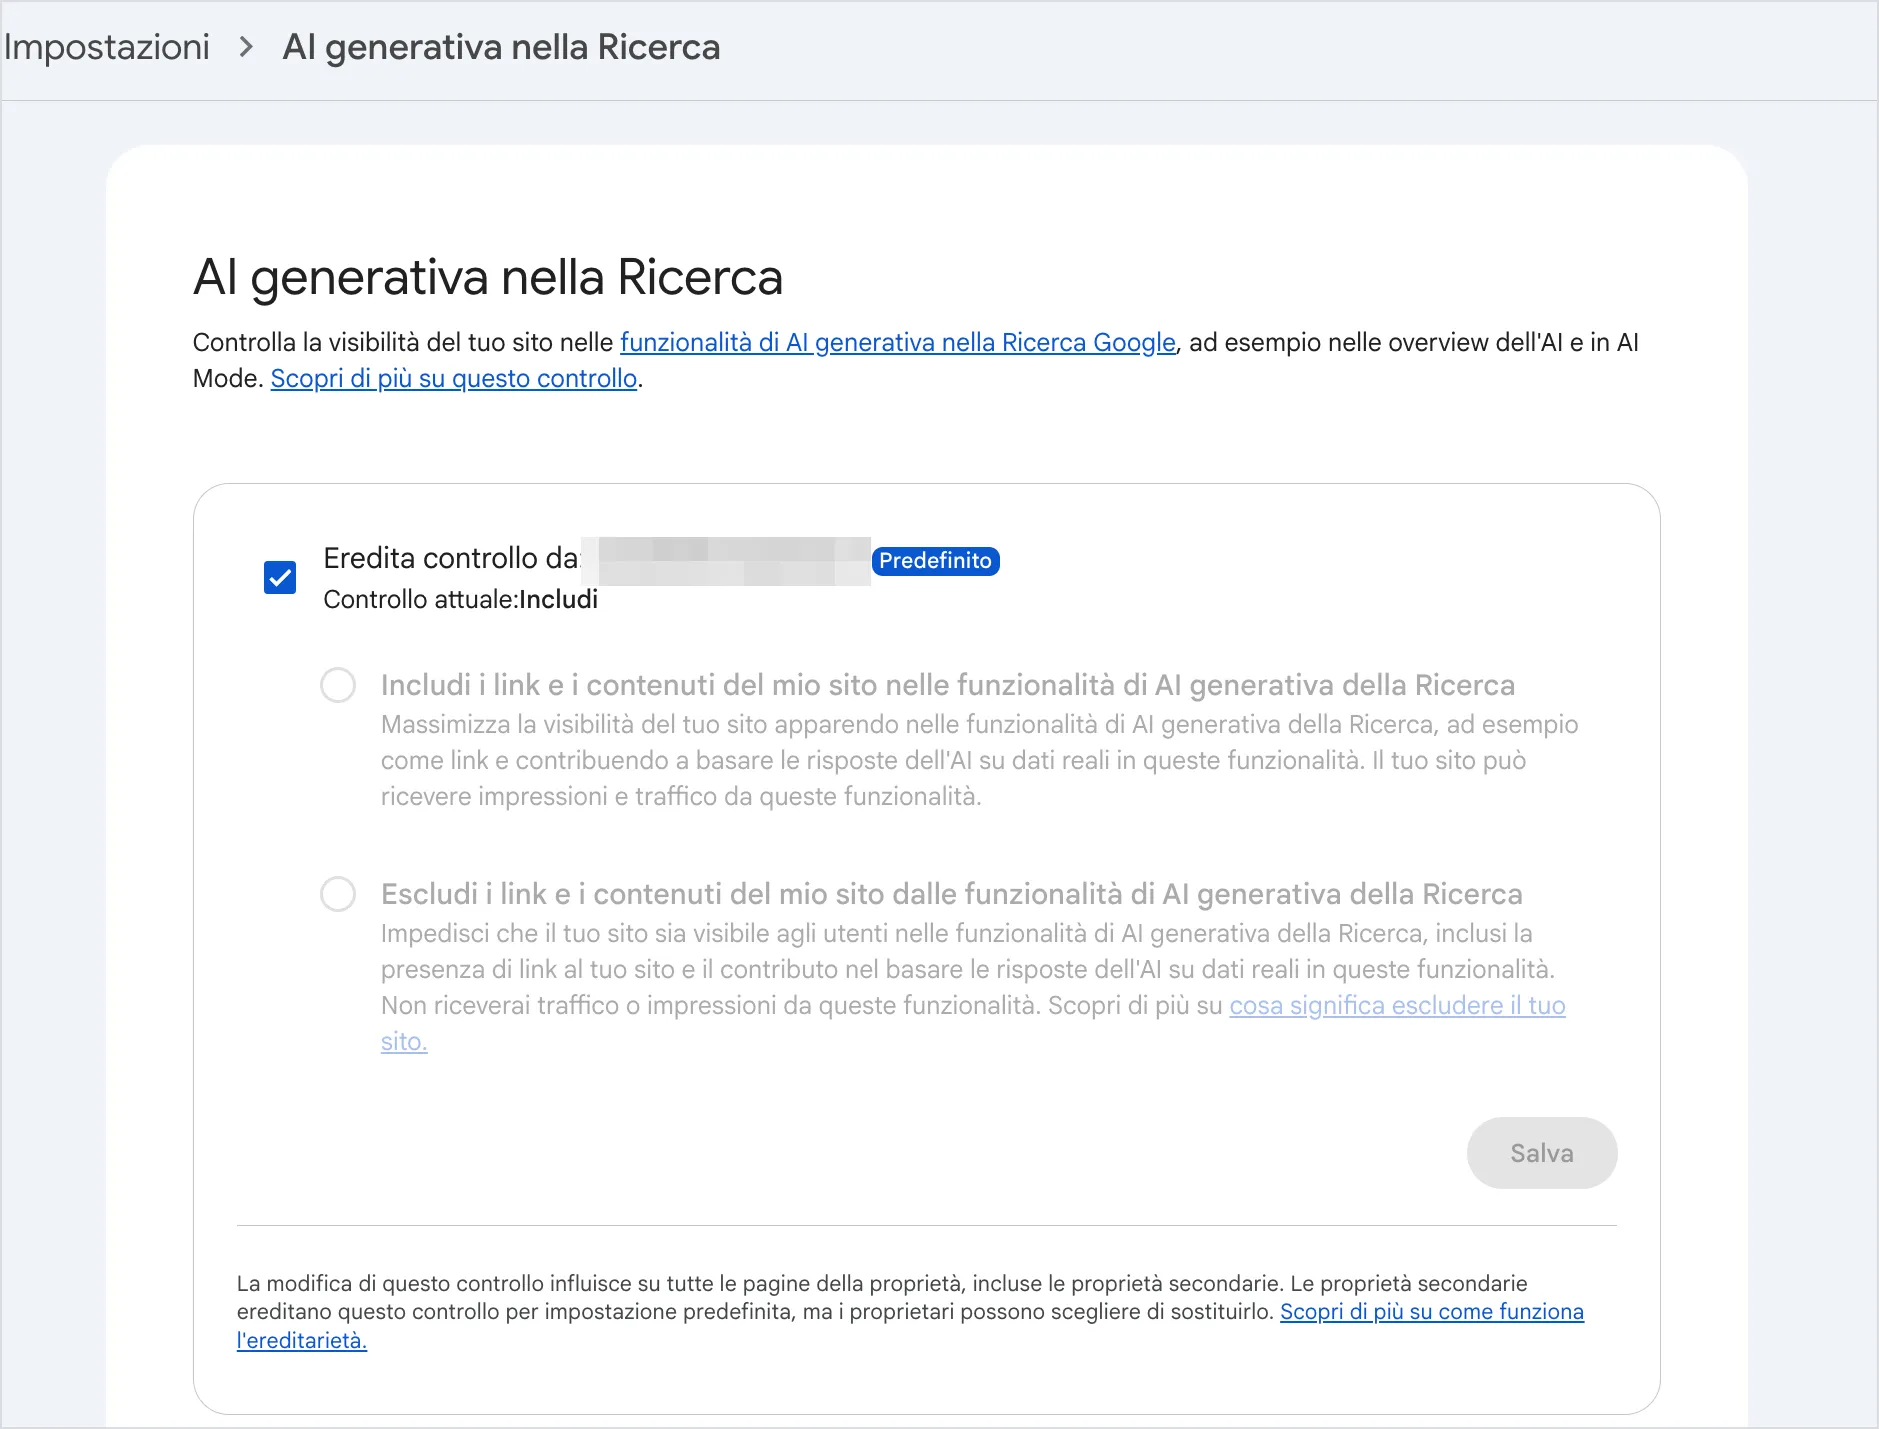
Vale anche il caso opposto, cioè chi dalle funzioni AI di Google vuole uscire davvero. A lungo un modo pulito non c’è stato: si poteva limitare lo snippet, pagando il prezzo anche sulle anteprime dei risultati classici, oppure bloccare Googlebot, uscendo da tutto. Da giugno 2026 Search Console sta distribuendo un controllo dedicato, il “Controllo dell’AI generativa della Ricerca”, che esclude il sito da AI Overviews, AI Mode e funzioni AI di Discover lasciandolo nei risultati tradizionali: Google dichiara che non è un segnale di ranking e che non riguarda l’addestramento dei modelli11. Il rollout è graduale: se in Impostazioni la voce non compare, significa che al tuo sito non è ancora arrivato.
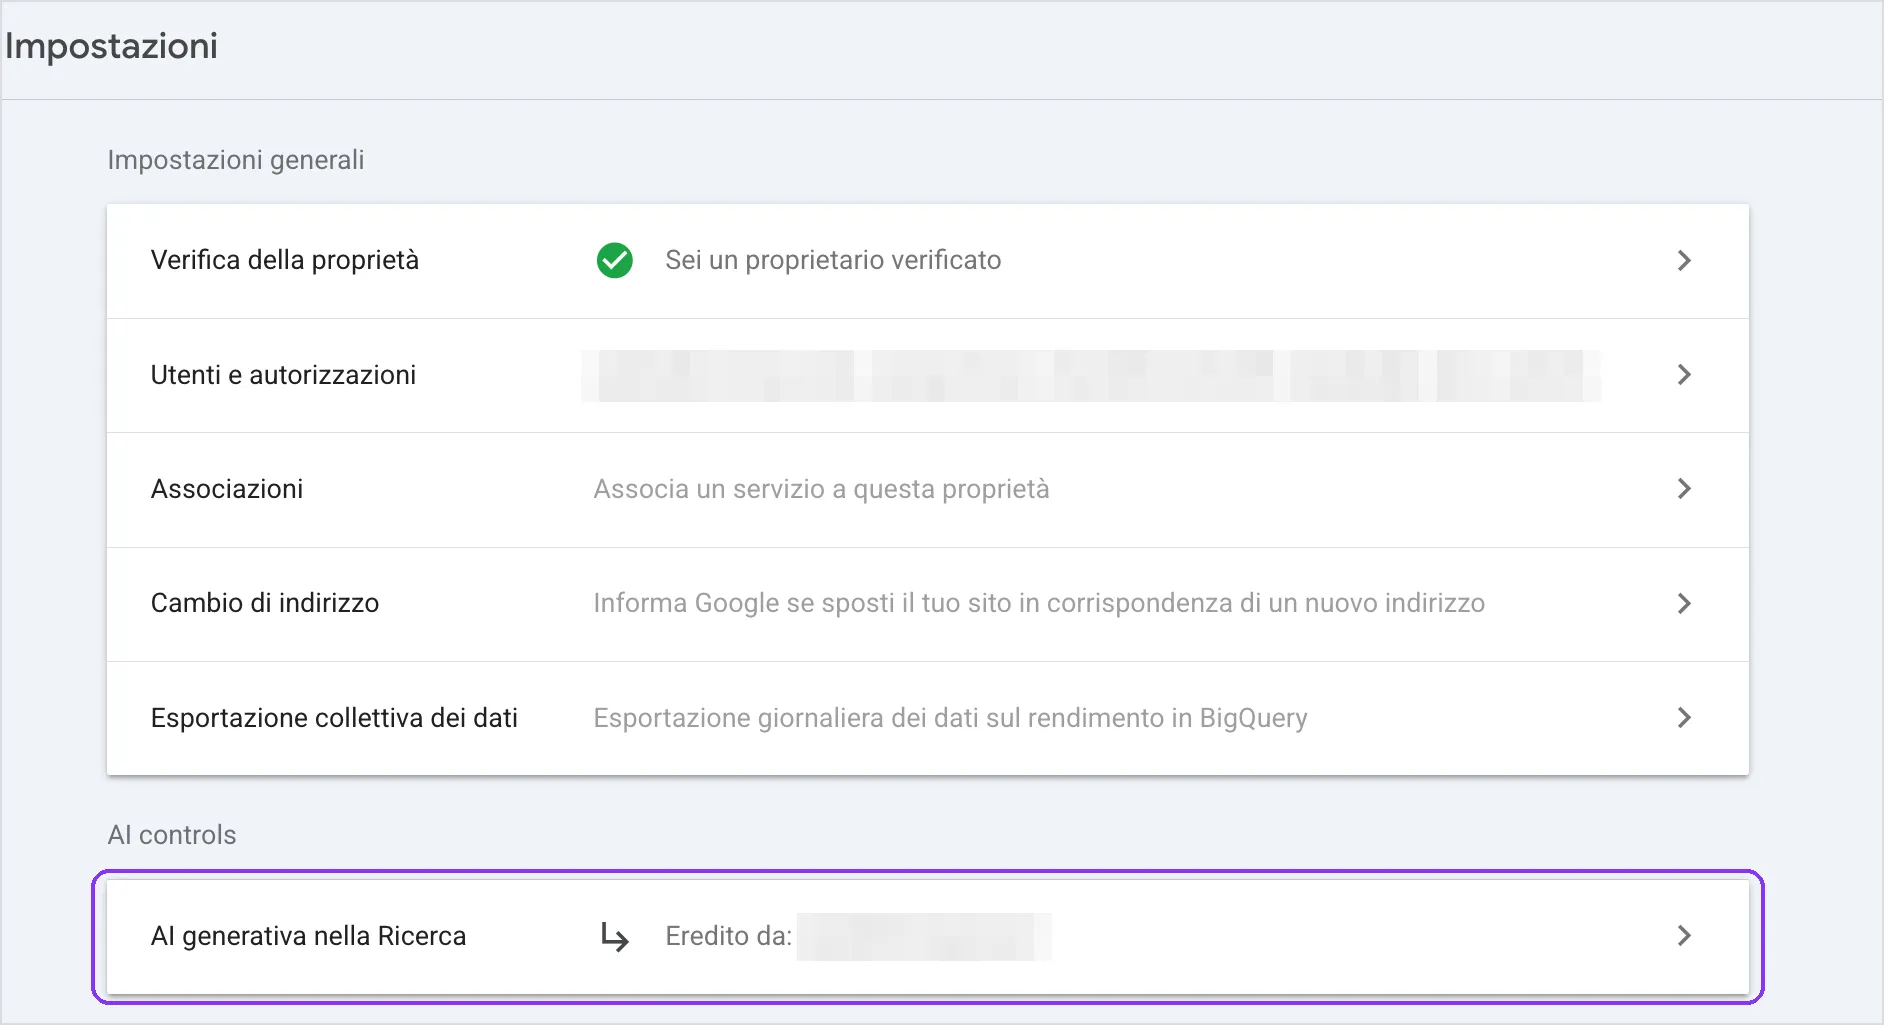
Aprendo la voce si arriva al controllo vero e proprio: due opzioni, includere o escludere, con l’impostazione ereditata per default dalla proprietà principale.
10. La citabilità: la parte che nessun tool misura da solo
Un sito può passare tutti i controlli precedenti ed essere comunque poco citabile: leggibile sì, ma senza niente che una risposta possa estrarre e riusare. Questa parte non si automatizza. Nei miei audit la valuto pagina per pagina, seguendo una griglia scritta di cinque principi:
| Principio | La domanda a cui risponde |
|---|---|
| Definizioni nette in apertura | Le sezioni chiave aprono con una risposta autosufficiente, estraibile fuori contesto? |
| Entità esplicite e coerenti | Brand, prodotti e concetti chiave sono nominati sempre nello stesso modo? |
| Formato domanda e risposta | Dove ha senso, i contenuti rispecchiano le domande reali degli utenti? |
| Dati e fatti verificabili | Ci sono numeri con fonte e data, o solo aggettivi? |
| Autorevolezza dichiarata | Si capisce chi c’è dietro: persone, storia, riconoscimenti? |
Ogni principio riceve un esito con l’evidenza testuale che lo motiva (“la pagina servizi apre con un claim di marketing, nessuna frase estraibile”). Guardo anche un segnale strutturale che anticipa molto: la quota di heading in forma di domanda, che sono gli agganci naturali delle risposte AI.
Perché questi principi aumentino la probabilità di essere citati l’ho raccontato nell’articolo su cos’è la GEO/AEO, dove riporto anche il primo studio controllato sul tema.
Cosa produce l’audit di leggibilità
La checklist qui sopra si può eseguire a mano, e per una prima diagnosi basta. Nel mio audit gli stessi controlli diventano decine di verifiche più il giudizio di citabilità dato sulla rubrica, e si condensano in un punteggio tecnico su 100 che rende confrontabili siti diversi e rilevazioni successive dello stesso sito. Tre caratteristiche del report contano più dell’elenco dei check:
- Ogni esito ha un’evidenza. Ciascuna criticità segnalata è accompagnata dalla prova concreta che la dimostra: l’URL controllato e ciò che il test ha realmente osservato su quella pagina. E i criteri di giudizio sono fissati per iscritto, così la rilevazione successiva valuta con lo stesso metro.
- Il campione è dichiarato. Il report elenca le pagine esaminate e il criterio con cui sono state scelte: il lettore non deve chiedersi “perché proprio queste?”.
- Il punteggio tecnico è separato da quello di visibilità. La leggibilità misura le cause on-site; se poi i motori citano il brand lo dice la misurazione di presenza e citazioni, fatta nella stessa rilevazione. E l’audit tecnico si ripete a ogni rilevazione periodica: ogni raccomandazione viene ricontrollata alla successiva, che dice se è stata applicata e che effetto ha avuto.
I falsi allarmi
Metà del lavoro, in questo tipo di audit, è non farsi ingannare dai test sbagliati:
| Il falso allarme | Cosa succede davvero |
|---|---|
| ”curl con user agent GPTBot risponde 403: siamo bloccati” | Può essere anti-spoofing che i bot veri, verificati per IP, non subiscono: servono log e citazioni |
| ”Blocchiamo Google-Extended così usciamo dalle AI Overviews” | Le AI Overviews dipendono da Googlebot, non da Google-Extended: per uscirne restando in Ricerca c’è ora il controllo dedicato di Search Console (punto 9) |
| “La sitemap ha lastmod recenti, la freshness è a posto” | Se le date visibili nei contenuti sono vecchie, il lastmod aggiornato da un deploy non convince nessuno |
| ”Abbiamo aggiunto lo schema markup: arriveranno più citazioni” | L’evidenza dice di no: il markup serve alla chiarezza dell’entità, le citazioni si guadagnano con contenuti e authority |
| ”Abbiamo pubblicato llms.txt: siamo pronti per le AI” | Il 97% di quei file non riceve richieste: è un complemento, non una leva |
| ”La CDN ci protegge dai bot, meglio così” | Se la protezione include i bot di search e i fetcher, protegge il sito anche dalle citazioni |
Il test fai da te, in tre passaggi
Per un primo esame non servono strumenti: il robots.txt letto con la tabella delle tre famiglie sotto mano, una navigazione delle pagine importanti a JavaScript disattivato, e il sorgente servito delle pagine chiave confrontato con ciò che vedi nel browser. Se i tre test passano, la base tecnica c’è.
Quello che è difficile testare da soli è il resto: cosa fa davvero la CDN con i bot veri, quanto i contenuti sono citabili, giudicati con un metro scritto, e la controprova finale, cioè se i motori citano il dominio. Se vuoi una verifica fatta con metodo, scrivimi: l’audit di leggibilità AI è una delle prime attività della mia consulenza GEO/AEO.
Fonti
-
BuzzStream, studio sui robots.txt dei 100 principali siti di news di Stati Uniti e Regno Unito (aprile 2026): il 79% blocca almeno un bot di training, il 71% almeno un bot di search o fetcher: buzzstream.com. Il monitoraggio continuo di Palewire su 1.156 testate: palewi.re ↩ ↩2
-
MERJ e Vercel, “The Rise of the AI Crawler” (dicembre 2024), misurazioni sul traffico della rete Vercel: vercel.com ↩ ↩2
-
Documentazione ufficiale dei crawler: OpenAI (GPTBot, OAI-SearchBot, ChatGPT-User): developers.openai.com; Anthropic (ClaudeBot, Claude-User, Claude-SearchBot): support.claude.com; Perplexity (PerplexityBot, Perplexity-User): docs.perplexity.ai ↩ ↩2
-
Google Search Central: “Google-Extended does not impact a site’s inclusion in Google Search nor is it used as a ranking signal”, developers.google.com/search/docs/crawling-indexing/google-common-crawlers; sul controllo delle funzioni AI tramite Googlebot e sul requisito di idoneità allo snippet per comparirvi: developers.google.com/search/docs/appearance/ai-features ↩ ↩2
-
Cloudflare: annuncio del blocco di default dei crawler AI per i nuovi domini (1 luglio 2025): cloudflare.com; nuovi default per scopo dal 15 settembre 2026: blog.cloudflare.com; ripartizione del traffico crawler AI per scopo: blog.cloudflare.com; crescita del crawling su richiesta utente nel 2025: blog.cloudflare.com ↩ ↩2
-
Google Search Central, documentazione sul crawl budget (aggiornata a dicembre 2025): developers.google.com; soglie TTFB come metrica di esperienza utente: web.dev/articles/ttfb ↩ ↩2
-
Dati Profound su circa 700.000 pagine (aprile 2026), riportati da Mike King, “How Page Speed Impacts ChatGPT and Perplexity Visibility”, iPullRank (maggio 2026): ipullrank.com ↩
-
Ahrefs, “We Tracked 1,885 Pages Adding Schema. AI Citations Barely Moved” (maggio 2026): ahrefs.com; Kurt Fischman, “Does Schema Markup Predict AI Citation?”, SSRN (2026): papers.ssrn.com; la posizione di Bing (Fabrice Canel) riportata da Search Engine Land: searchengineland.com; il commento di John Mueller riportato da Search Engine Roundtable (gennaio 2026): seroundtable.com ↩ ↩2 ↩3 ↩4
-
La proposta originale è di Jeremy Howard (Answer.AI, settembre 2024): answer.ai. Adozione: tracking Originality.ai su oltre 3 milioni di siti: originality.ai; sulla generazione automatica di Shopify: Casey Burridge, analisi su dati HTTP Archive (giugno 2026): caseyrb.com. Lettura: Ahrefs, studio sui log di 137.210 domini (giugno 2026): ahrefs.com. La dichiarazione di John Mueller (giugno 2025): bsky.app; il paragone col meta tag keywords, riportato da Search Engine Journal: searchenginejournal.com. Chi richiede davvero il file: nello stesso studio Ahrefs la prima categoria di richiedenti sono i tool di audit SEO (21,7%, più di tutti i bot AI sommati), e i fetch di Googlebot osservati (~900 in un mese) sono scansione di routine degli URL scoperti, non uso del file; Lighthouse verifica llms.txt nella categoria sperimentale “Agentic browsing”: developer.chrome.com ↩ ↩2 ↩3
-
Ahrefs, “Do AI Assistants Prefer to Cite Fresh Content?” (luglio 2025, circa 17 milioni di citazioni analizzate): ahrefs.com; Seer Interactive, studio su recency e visibilità AI (giugno 2025): seerinteractive.com ↩ ↩2
-
Google Search Console Help, “Controllo dell’AI generativa della Ricerca”: l’esclusione copre AI Overviews, AI Mode e le funzioni di AI generativa del feed personalizzato; non è un segnale di ranking e non riguarda l’addestramento dei modelli (per quello c’è Google-Extended); il rollout dichiarato è “per un sottoinsieme di proprietari di siti web” in fase di test: support.google.com ↩