llms.txt: cos’è, da dove nasce e perché oggi è sovrastimato
 Di Nicola Burei
Indice dei contenuti
Nei miei corsi, llms.txt è diventato una presenza fissa nel giro di domande: qualcuno l’ha letto in un articolo, qualcuno se l’è visto proporre da un tool o da un’agenzia, e la domanda di arrivo è sempre la stessa: “lo dobbiamo fare anche noi?”. Questo articolo mette in fila le risposte: cos’è il file llms.txt, da quale problema nasce, cosa promette e perché, dati alla mano, oggi lo considero lo strumento più sovrastimato del discorso GEO. Con un’eccezione vera, che vale la pena conoscere.
Che cos’è: un indice ragionato dei contenuti
llms.txt è un file di testo in formato markdown, pubblicato nella radice del sito (esempio.it/llms.txt), che propone ai modelli linguistici un indice ragionato dei contenuti: un titolo, un riassunto di poche righe e sezioni di link alle pagine importanti, ognuno con una breve descrizione di cosa c’è dietro.
Attenzione a cosa non è: il file non contiene le pagine e non evita ai modelli di scaricarle; i contenuti vanno comunque letti uno per uno. Quello che promette è di risparmiare l’esplorazione alla cieca: invece di ricostruire la struttura del sito da menu e link interni, il modello troverebbe in un solo file l’elenco di ciò che conta, con le indicazioni per scegliere cosa aprire.
La struttura prevista dalla specifica è semplice:
# Nome del sito

> Un riassunto di poche righe: chi sei, di cosa parlano i contenuti

Eventuali note utili a interpretare le pagine elencate

## Sezione (per esempio: Servizi)

- [Titolo della pagina](https://esempio.it/pagina.md): breve descrizione

## Optional

- [Contenuti secondari](https://esempio.it/altro.md)
La sezione “Optional” ha un significato tecnico: segnala i link che un modello può saltare se ha poco contesto a disposizione.
La proposta prevede inoltre che le pagine importanti esistano anche in versione markdown pulita, allo stesso URL con .md aggiunto in fondo (esempio.it/servizi → esempio.it/servizi.md): è in queste versioni, spogliate di navigazione, script e banner, che la lettura diventa davvero più leggera per un modello.
La pratica ha poi aggiunto una variante non prevista dalla specifica originale, llms-full.txt, un unico file che contiene il testo integrale di tutte le pagine1. Quanto possa pesare questa idea l’ho misurato mentre scrivevo: il file llms-full.txt della documentazione per sviluppatori di Anthropic, scaricato a luglio 2026, supera i 90 MB di testo in un file solo. Nato per aggirare finestre di contesto troppo piccole, è cresciuto fino a non entrare in nessuna finestra di contesto.
Il malinteso più frequente che incontro sta nel nome: “llms.txt” suona come “il robots.txt delle AI”, cioè un file di regole che i bot devono rispettare. Il parente giusto, semmai, è la Sitemap XML: anche llms.txt è un elenco di URL, solo che è selezionato e commentato invece che completo e spoglio. Mettere i tre file in fila chiarisce i ruoli:
| File | Cosa dichiara | Stato |
|---|---|---|
| robots.txt | Chi può accedere a cosa | Standard formale (RFC 9309), rispettato dai crawler seri |
| sitemap.xml | L’elenco completo degli URL indicizzabili | Standard di fatto, consumato da tutti i motori di ricerca |
| llms.txt | Una selezione curata di contenuti per i modelli | Proposta: nessun motore generativo dichiara di usarla |
llms.txt non blocca e non autorizza nessuno: chi vuole governare l’accesso dei bot AI lavora su robots.txt e CDN. È un’offerta di contenuto, che i destinatari sono liberi di ignorare. E, come vedremo, la ignorano.
Da dove nasce: un problema di contesto degli assistenti di sviluppo
La proposta ha una data e una firma: 3 settembre 2024, Jeremy Howard, cofondatore di Answer.AI e figura nota nella comunità del machine learning1.
Il problema che voleva risolvere è concreto e circoscritto: le finestre di contesto dei modelli sono troppo piccole per la maggior parte dei siti interi, e convertire HTML complesso in testo pulito è difficile e impreciso. Il caso d’uso che Howard aveva in mente è scritto nella proposta stessa: gli ambienti di sviluppo, dove un assistente AI deve accedere in fretta alla documentazione di una libreria o di un’API. I primi ad adottarlo, non a caso, sono stati progetti di documentazione tecnica.
Vale la pena rileggere cosa promette il testo della proposta, perché è più onesto di molti articoli che lo hanno raccontato. L’aspettativa dichiarata è che llms.txt serva “principalmente per l’inferenza”, cioè nel momento in cui un utente sta già chiedendo assistenza su quei contenuti; sull’addestramento la proposta si limita a un “forse, se l’adozione diventasse ampia”. Da nessuna parte promette più visibilità o più citazioni a chi pubblica il file. Quella promessa l’ha aggiunta il passaparola di settore, dopo.
Quanto si è diffuso, e perché
I numeri dell’adozione sono reali: i siti con un llms.txt sono cresciuti di 8,8 volte in un anno secondo il tracking di Originality.ai, complice Shopify, che ha iniziato a generarlo in automatico per i suoi negozi; Wix lo ha esteso a tutti i propri siti a maggio 2026, e quasi ogni tool di visibilità AI offre un generatore che lo crea in un clic. Nello stesso mese, secondo i dati ripresi da Wix, “llms.txt” valeva circa 119.000 ricerche mensili su Google2.
Questa curva però va letta per quello che è. Quando un file si crea con un clic, o ce lo si ritrova già creato dal proprio CMS, l’adozione misura quanto è facile generarlo, non quanto viene usato. E il ciclo si autoalimenta: i tool di audit aggiungono il check “llms.txt mancante”, il check fa sembrare il file importante, i CMS lo generano di default, l’adozione cresce, e la crescita viene citata come prova che il file conta. In nessun punto di questo giro compare un motore AI che lo legge.
I dati: quasi nessuno legge questi file
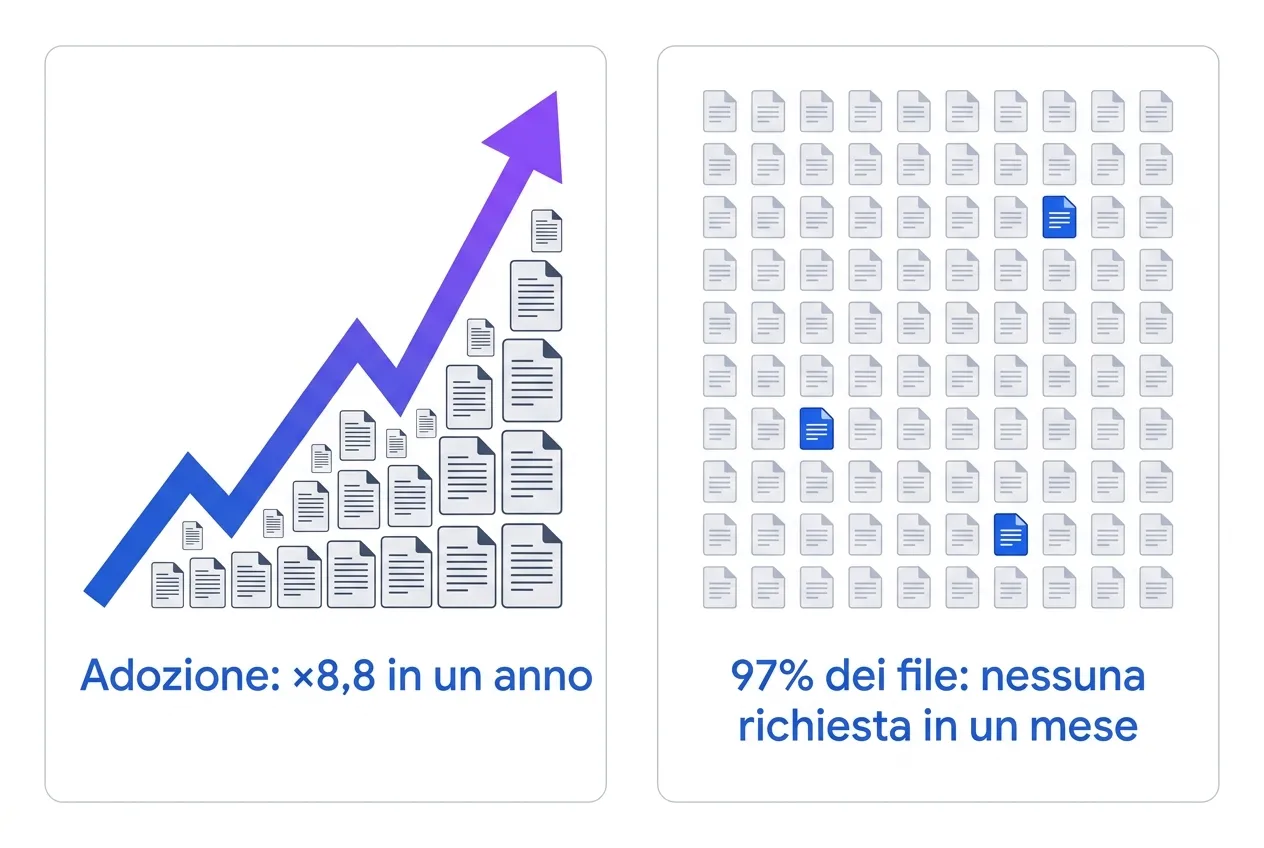
La misura più solida disponibile è di giugno 2026: Ahrefs ha analizzato i log di 137.210 domini, dei quali circa 38.000 pubblicano un llms.txt valido, contando chi richiede davvero quei file. Il risultato: il 97% dei file non ha ricevuto nemmeno una richiesta in tutto maggio 20263. Non poche richieste: zero.
Il restante 3% racconta una storia ancora più istruttiva. La prima categoria di richiedenti sono i tool di audit SEO, con il 21,7% delle richieste (categoria in cui Ahrefs dichiara di contare anche i propri crawler): più di tutti i bot AI messi insieme, che anche nella lettura più generosa si fermano al 19,5%. Googlebot compare con circa 900 richieste in un mese sull’intero campione, la normale scansione di routine di un crawler che rivisita gli URL che ha scoperto, non un segnale d’uso. E il secondo bot AI per numero di richieste è Claude Code, un agente di programmazione: un dettaglio che sembra una curiosità e invece è l’indizio giusto: ci torno più avanti.
Le dichiarazioni: chi dovrebbe usarlo dice di non usarlo
È raro che dati e dichiarazioni ufficiali siano così allineati. John Mueller (Google), a giugno 2025: “nessun sistema AI oggi usa llms.txt”.
Nello stesso intervento c’è anche il paragone che ha fatto il giro del settore, quello col meta tag keywords: il tag con cui, ai tempi dei primi motori di ricerca, ogni sito dichiarava da sé le parole chiave per cui voleva essere trovato. Finì pieno di abusi e i motori smisero di leggerlo, perché una dichiarazione che non si può verificare vale meno dei contenuti che si possono leggere. Per Mueller llms.txt appartiene alla stessa famiglia: un’autodichiarazione che i motori non hanno motivo di credere sulla parola, potendo guardare il sito vero4.
Gary Illyes, dal palco del Search Central Live di luglio 2025: Google non supporta llms.txt e non ha in programma di farlo4.
E a giugno 2026, di nuovo Mueller: “credo che nessuno lo sappia: per ora è pura speculazione (il file esiste da anni e nessun sistema AI lo usa: cosa ci dice questo?)”. Con un’aggiunta ironica che merita la citazione: se serve un LLM per generare il tuo llms.txt, non significa che l’LLM potrebbe crearselo da solo quando gli serve?5
Dall’altra parte del tavolo, il silenzio: OpenAI, Anthropic e Perplexity documentano con precisione i propri crawler, come trattano il robots.txt, quali IP usano; in nessuna di quelle pagine llms.txt è menzionato tra le cose che i loro bot leggono o rispettano4. A oggi nessuna piattaforma di ricerca AI dichiara che i propri sistemi lo consultino per scegliere o citare fonti.
Qui è facile confondersi, perché le stesse aziende il file lo pubblicano eccome: abbiamo già parlato del file llms-full.txt della documentazione di Anthropic, e anche le doc per sviluppatori di OpenAI e Perplexity espongono il proprio llms.txt (verificato a luglio 2026). Ma lo fanno da proprietarie di siti, perché gli agenti dei programmatori leggano la loro documentazione: è l’eccezione a cui arrivo tra poco. Pubblicare il file per i propri lettori è una cosa; dichiarare che il proprio motore lo legge quando sceglie cosa citare è un’altra. La prima succede, la seconda no.
Anche dentro Google, la mano destra e la sinistra
C’è un episodio che fotografa lo stato di llms.txt meglio di qualsiasi analisi, e riguarda proprio Google.
La guida ufficiale di Search Central dice che per comparire nelle esperienze AI di Google non servono file speciali.
Tuttavia, Lighthouse, lo strumento di audit di Chrome, ha introdotto un controllo sperimentale che verifica la presenza di llms.txt nella categoria “Agentic browsing”, definendolo una “convenzione emergente” e ipotizzando che senza il file gli agenti “potrebbero” impiegare più tempo a capire la struttura del sito6.
Sono due indicazioni, provenienti dalla stessa azienda, che puntano in direzioni opposte: anche se il condizionale di Lighthouse ammette che il beneficio è solo un’ipotesi.
Poi c’è il finale di stagione: a fine 2025 la piattaforma CMS usata da Google per la documentazione per sviluppatori ha iniziato a supportare llms.txt, e il file è comparso su molti siti di documentazione di Google. Il team Search lo ha rimosso dai propri nel giro di un giorno, mentre gli altri team lo hanno lasciato dove il CMS lo aveva messo. Quando a gennaio 2026 hanno chiesto a Mueller se quei file fossero un endorsement, la risposta è stata: “sarei tentato di dire qualcosa di sarcastico, vista la frequenza con cui salta fuori, ma per essere diretto: no”7.
Il paradosso è istruttivo: perfino dentro Google llms.txt esiste non perché qualcuno lo consuma, ma perché gli strumenti lo generano. È esattamente la dinamica dell’adozione in tanti altri siti.
Le prove a favore, lette da vicino
L’argomento pro llms.txt meglio documentato è di Crystal Carter (Wix), che ha analizzato oltre 1.400 file: llms.txt viene scansionato e indicizzato da Google (circa 120.000 file nell’indice a maggio 2026), in qualche caso si posiziona per keyword organiche, e occasionalmente affiora come fonte in AI Mode o in Perplexity8.
Sono osservazioni verificabili e non le contesto. Contesto cosa dimostrano: che Google tratta llms.txt come una qualsiasi pagina web. La scansiona come scansiona tutto, la indicizza se lo ritiene, e i sistemi AI ancorati alla ricerca possono pescarla come pescano qualunque risultato. Il protocollo non c’entra: nessuno di quei sistemi sta “leggendo llms.txt” nel senso della proposta; stanno attingendo al normale indice di ricerca, e il file ci è finito dentro da pagina qualunque.
Questo comportamento ha peraltro un effetto collaterale concreto: il tuo llms.txt può comparire in SERP, spoglio e fuori contesto, in mezzo alle pagine che vorresti mostrare. Lo stesso Mueller ha osservato che un noindex sul file “avrebbe senso”; su un .txt si implementa con l’header HTTP X-Robots-Tag9. Trovo che questo dettaglio riassuma bene il rapporto tra llms.txt e i motori: il comportamento più concreto che Google suggerisce in relazione al file è proprio quello che conviene disattivarne l’indicizzazione.
Restano i report aneddotici, circolati soprattutto a metà 2025: log individuali in cui un bot di OpenAI scarica un llms.txt a intervalli regolari10. Possibile, ma non generalizzabile: lo studio sui 137.210 domini è arrivato dopo, con la potenza statistica per pesare quegli episodi sul totale. Il totale è il 3% di file richiesti, in maggioranza da tool di audit.
L’eccezione vera: gli agenti di sviluppo
Il quadro cambia in un ecosistema preciso: gli agenti di programmazione e la documentazione tecnica.
Il secondo bot AI per richieste nei log di Ahrefs, dicevamo, è Claude Code: chi sviluppa software usa assistenti che leggono da soli la documentazione delle librerie, e per quegli strumenti una mappa in markdown è esattamente ciò che serve. È il caso d’uso per cui Howard aveva scritto la proposta, ed è l’unico in cui il file oggi lavora davvero.
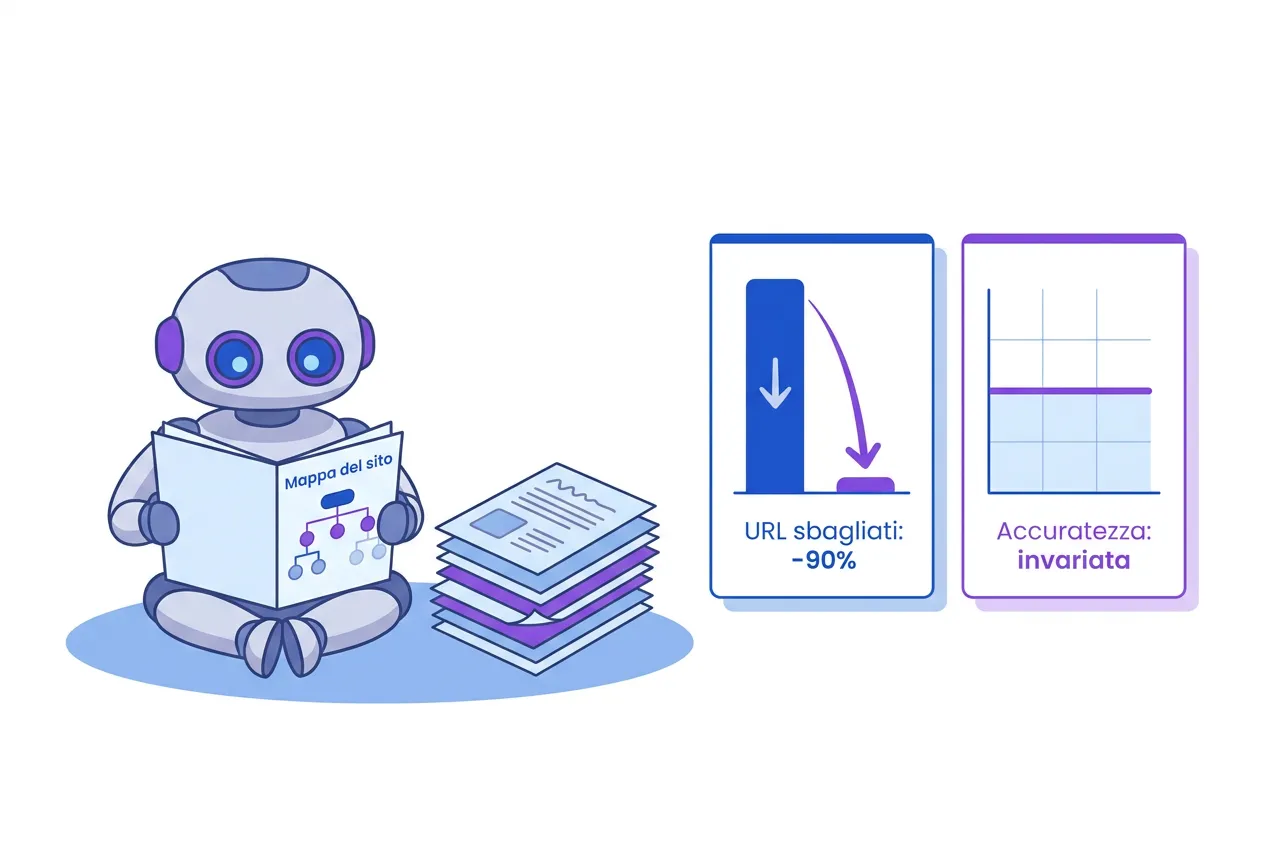
Da luglio 2026 questa eccezione ha anche una misura. Mintlify, la piattaforma che ospita la documentazione di aziende come Anthropic, ha preso 20 siti di documentazione e li ha fatti interrogare da due agenti di coding, Claude Code e Codex, servendo a ogni giro le stesse pagine in uno di quattro formati: HTML, markdown puro, markdown con un link a llms.txt in fondo, markdown con l’intero llms.txt incorporato nella pagina. In tutto 2.400 prove. Il risultato: basta il link a llms.txt per ridurre di circa il 90% gli URL inesistenti che gli agenti tentano di aprire, con meno richieste sprecate e meno token consumati. Il dato più interessante però è l’altro: l’accuratezza delle risposte non cambia, resta alta in tutti i formati11. La mappa rende gli agenti più efficienti, non più bravi. Per chi paga i token è un beneficio reale; per chi cerca visibilità, no.
Coerente con tutto questo è anche chi pubblica llms.txt con convinzione: i siti di documentazione tecnica, da Anthropic a OpenAI a Stripe. E Anthropic, nelle linee guida per chi costruisce strumenti per agenti, indica llms.txt come il posto in cui un agente si aspetta di trovare la documentazione in formato leggibile11. I casi in cui il file funziona hanno tre tratti in comune: gli utenti sono agenti, il contenuto è documentazione, il beneficio è operativo. Nessuno dei tre è “essere citati di più nelle risposte di ChatGPT”.
Cosa consiglio
| Il tuo caso | Il mio consiglio |
|---|---|
| Documentazione tecnica per sviluppatori | Qui il beneficio è misurato: pubblica llms.txt (ed eventualmente llms-full.txt) e tienilo aggiornato |
| Sito aziendale, e-commerce, blog | Costo quasi zero, beneficio non dimostrato: se vuoi farlo va bene, in fondo alla lista e senza aspettarti visibilità, almeno oggi (in futuro si vedrà) |
| Un tool o un fornitore lo presenta come priorità GEO | Chiedi quale motore lo userebbe: a oggi la risposta onesta è “nessuno” |
Se decidi di pubblicarlo, tre accortezze:
- Primo: deve dire la verità, perché un llms.txt generato una volta e mai più toccato diventa una mappa che mente sui contenuti reali.
- Secondo: valuta l’header
X-Robots-Tag: noindex, se non vuoi ritrovare il file in SERP - Terzo: ogni tanto cerca nei log del server chi lo richiede davvero; è la verifica più economica che esista, e se un giorno i motori inizieranno a leggerlo te ne accorgerai lì prima che dai comunicati.
Ed effettivamente le cose possono cambiare, è giusto dirlo: la proposta è sensata, il costo per un motore di supportarla sarebbe basso, e se domani una piattaforma annunciasse di usarla questo articolo andrebbe aggiornato. È il vantaggio di ancorare le opinioni ai dati: si sa esattamente cosa dovrebbe succedere per cambiarle.
Quello che non va fatto, oggi, è scambiare llms.txt per una strategia. Se l’obiettivo è essere letti e citati dai motori generativi, le leve con evidenza alle spalle sono altre: contenuti presenti nell’HTML servito, robots.txt e CDN che non respingono i bot di search e i fetcher, pagine da cui una risposta può estrarre definizioni e fatti verificabili. Le ho messe in fila nella checklist di leggibilità AI, dove llms.txt, non per caso, non è indicato come una priorità; e perché quelle leve aumentino le probabilità di essere citati l’ho raccontato nell’articolo su cos’è la GEO/AEO.
Se questa domanda ti è venuta durante un corso, o te la stai facendo in azienda, ne parlo volentieri: nei percorsi di formazione dedico alla GEO/AEO lo spazio che i dati giustificano, e se vuoi capire come è messo il tuo sito scrivimi.
Fonti
-
Jeremy Howard, “The /llms.txt file” (Answer.AI, 3 settembre 2024): answer.ai; il testo completo della proposta, da cui vengono le citazioni di questa sezione: llmstxt.org. La variante llms-full.txt non compare nella specifica ed è documentata dagli strumenti che l’hanno diffusa, per esempio Mintlify: mintlify.com ↩ ↩2
-
Adozione: tracking Originality.ai su oltre 3 milioni di siti: originality.ai; sulla generazione automatica di Shopify: Casey Burridge, analisi su dati HTTP Archive (giugno 2026): caseyrb.com; il rollout di Wix: support.wix.com; il volume di ricerca (dati Glimpse) è riportato in Crystal Carter, “7 LLMs.txt myths we should clear up”, Wix AI Search Lab (luglio 2026): wix.com ↩
-
Ahrefs, “We Analyzed 137K Sites: 97% of llms.txt Files Never Get Read” (giugno 2026), analisi dei log di maggio 2026 su 137.210 domini, dei quali il 28% (circa 38.000) pubblica un llms.txt valido: ahrefs.com. Lo studio avverte che “richiesto” non significa “letto”: ogni percentuale d’uso è un tetto massimo, non una stima dell’uso reale ↩
-
La dichiarazione di John Mueller (giugno 2025): bsky.app; il paragone col meta tag keywords, riportato da Search Engine Journal: searchenginejournal.com; la posizione di Gary Illyes al Search Central Live Deep Dive (luglio 2025), riportata da Search Engine Roundtable: seroundtable.com. La documentazione dei crawler in cui llms.txt non compare: OpenAI: developers.openai.com; Anthropic: support.claude.com; Perplexity: docs.perplexity.ai ↩ ↩2 ↩3
-
I commenti di John Mueller su Reddit (2026), riportati da Roger Montti, “Google Says LLMs.txt Is Purely Speculative… For Now”, Search Engine Journal (giugno 2026): searchenginejournal.com ↩
-
Google, sulle funzioni AI della ricerca: “non servono file speciali”: developers.google.com; il check sperimentale di Lighthouse nella categoria “Agentic browsing”: developer.chrome.com ↩
-
La comparsa del file sui doc di Google Search (3 dicembre 2025): Barry Schwartz, Search Engine Roundtable: seroundtable.com; la ricostruzione completa e il “no” di Mueller sull’endorsement (gennaio 2026): seroundtable.com ↩
-
Crystal Carter, “7 LLMs.txt myths we should clear up”, Wix AI Search Lab (luglio 2026): wix.com ↩
-
John Mueller su Bluesky (luglio 2025), riportato da Search Engine Roundtable: seroundtable.com ↩
-
Barry Schwartz, “Is OpenAI Crawling LLMs.txt Files? Google Says It Won’t”, Search Engine Roundtable (luglio 2025): seroundtable.com ↩
-
Aadit Shah, “Docs URL Benchmark: Markdown & llms.txt > HTML”, Mintlify (17 luglio 2026), benchmark open source su 2.400 esecuzioni con Claude Code e Codex: mintlify.com, repo: github.com; le linee guida di Anthropic per chi scrive strumenti per agenti: anthropic.com ↩ ↩2