Misurare la visibilità AI: metriche e metodo
 Di Nicola Burei
(aggiornato il )
Indice dei contenuti

“Quanto siamo visibili su ChatGPT?” è una domanda che fino a poco tempo fa non aveva una risposta seria. Oggi ce l’ha, a patto di usare metriche precise e un metodo di rilevazione onesto. E il metodo conta più dello strumento: una ricerca pubblicata nel 2026 mostra che le classifiche di visibilità AI lette una volta sola sono in gran parte rumore statistico1. In questo articolo descrivo come misuro la visibilità nei motori di risposta AI per i miei clienti: le metriche che uso, come costruisco il set di domande e quante risposte servono perché un confronto abbia senso.
Le tre metriche di base

| Metrica | La domanda a cui risponde | Perché conta |
|---|---|---|
| Presenza | Il brand viene nominato nella risposta? | Dice se i modelli ti considerano parte del tuo mercato: la percentuale di risposte in cui compari sul set di domande rilevanti |
| Citazione | Il tuo sito è tra le fonti della risposta? | Vale più della menzione: porta un link, qualifica il sito come riferimento e tende a rafforzarsi nel tempo |
| Share of voice | Che quota delle menzioni ti prendi rispetto ai concorrenti? | È la metrica più utile per decidere: mette la tua presenza in rapporto a quella di chi compete con te |
Due precisazioni cambiano il valore di questi numeri. Sulla presenza c’è una regola che sembra un dettaglio e non lo è: la menzione conta solo se la domanda non nomina il brand. Se chiedo “meglio X o Y?” e la risposta parla di X, il modello sta eseguendo la consegna, non è visibilità guadagnata. Insieme alla presenza registro anche la posizione della prima menzione: aprire una risposta che elenca cinque operatori vale più che chiuderla.
Sulla share of voice (alcuni strumenti la chiamano “share of model”): una presenza del 30% vale poco se un competitor è al 70%, e molto se il resto del mercato è frammentato al 5%. E va letta motore per motore, non solo aggregata: si può essere primi su Google e invisibili su ChatGPT, o dominare su ChatGPT e non esistere su Perplexity, perché ogni sistema recupera e cita le fonti con logiche proprie2.
Come sei descritto: quello che le percentuali non dicono
Due brand con la stessa presenza possono trovarsi in situazioni opposte: uno raccomandato esplicitamente con descrizioni ricche, l’altro liquidato in un elenco o menzionato con riserve. Per questo ogni menzione va giudicata anche nel merito, su tre dimensioni:
| Dimensione | La domanda | Come si giudica |
|---|---|---|
| Tono | Sei raccomandato, presentato positivamente, elencato in modo neutro o accompagnato da riserve? | Con una classificazione fissa, dallo “sconsigliato esplicitamente” al “raccomandato come scelta migliore” |
| Profondità | Sei solo un nome in un elenco, una frase su cosa fai e per chi, o un approfondimento con dettagli e casi d’uso? | Una menzione secca e una raccomandazione argomentata non valgono uguale |
| Accuratezza | Quello che la risposta dice di te è vero? | Contro una scheda dei fatti compilata prima della misurazione (identità, offerta, geografia, concorrenti reali) |
L’accuratezza merita un passaggio in più, perché è il terreno degli errori più dannosi. Oltre alle risposte alle domande di mercato, chiedo a ogni motore un profilo completo dell’azienda e lo confronto con la scheda dei fatti, dimensione per dimensione. Gli scostamenti si classificano per gravità: un’informazione imprecisa o datata sfoca il posizionamento; un’identità confusa con un’altra azienda, un’offerta sbagliata o concorrenti fuorvianti lo danneggiano, e vanno trattati come criticità, ciascuna con l’evidenza testuale che la prova.
Un vincolo vale su tutta questa parte: i giudizi si danno leggendo solo il testo della risposta, su scale scritte prima e versionate. Se le scale cambiano, il confronto qualitativo con le rilevazioni precedenti si sospende e lo si dichiara, altrimenti si finisce per confrontare metri diversi.
Costruire il set di domande
La misurazione vale quanto il set di domande su cui la fai. I criteri che uso:
- Domande vere: quello che un cliente chiederebbe davvero a un’AI (“qual è il miglior gestionale per uno studio dentistico?”), non le keyword secche della SEO.
- Copertura per tema e per stadio: le domande devono toccare sia la categoria in generale sia prodotti, funzionalità e settori specifici, distribuite lungo il percorso di acquisto, da “che cos’è X?” a “quanto costa Y?”. I motori non trattano tutte le domande allo stesso modo: su quelle generali tendono a rispondere a memoria e a nominare pochi brand, su quelle comparative cercano sul web e citano fonti terze. Per questo un set concentrato su un solo tipo di domanda misura un solo pezzo del percorso, e può far sembrare invisibile un brand che altrove è forte.
- Il brand mai nelle domande di visibilità: chiedere “quanto è bravo il brand X?” inquina la misura. Le domande comparative che nominano il brand si possono includere, ma con un ruolo dichiarato: servono al confronto diretto con un competitor e restano fuori dal calcolo di presenza e share of voice.
- Un set stabile, con identificativi stabili: le stesse domande a ogni rilevazione, ognuna con un suo id che non cambia mai; le domande nuove si aggiungono in coda, quelle ritirate si tolgono senza riciclarne l’id. Sembra pignoleria, ed è quello che rende leggibili le serie storiche.
Quante? Nei miei progetti consiglio tra le 15 e le 20: abbastanza da coprire temi e stadi diversi, e abbastanza poche da poterle ripetere più volte a ogni rilevazione senza far esplodere i costi.
A memoria o cercando sul web: due condizioni di misura
Ogni domanda si può porre in due condizioni. Nella prima il modello risponde solo con quello che ha imparato durante l’addestramento; nella seconda ha a disposizione la ricerca web e decide da solo se e quanto usarla: è il comportamento normale di ChatGPT e degli altri assistenti. In gergo le due condizioni si chiamano parametric e grounded3; Perplexity fa eccezione, perché cerca sul web per costruzione.
Il confronto tra le due è la parte più diagnostica dell’intera misurazione, perché dice da dove nasce un problema e con quali tempi si può correggere:
| A memoria (parametric) | Cercando sul web (grounded) | |
|---|---|---|
| Cosa misura | Quanto il brand è entrato nella conoscenza del modello | Cosa dicono le fonti online in quel momento |
| Se l’errore compare qui | Sta nei pesi del modello | Sta in una fonte web sbagliata o datata |
| Come si corregge | Lavorando sulla coerenza delle fonti che i modelli leggeranno in addestramento | Individuando e correggendo la fonte che alimenta l’errore |
| Quando si vede l’effetto | Ai cicli di addestramento successivi | In tempi molto più brevi, tipicamente settimane |
C’è anche un dettaglio di efficienza: finché i modelli restano gli stessi, la risposta a memoria non può cambiare tra una rilevazione e l’altra, perché dipende solo dai pesi. La misuro una volta per ogni versione dei modelli; nelle rilevazioni periodiche ripeto solo la parte con ricerca web, che è quella che si muove.
Quanto rumore c’è in questi numeri
Chi ripete la stessa domanda a un motore AI ottiene risposte diverse: i modelli sono costruiti per variare, e ogni citazione è una delle tante possibili. SparkToro ha misurato che gli strumenti AI restituiscono una lista di brand diversa in oltre il 99% dei casi in cui si ripete la stessa domanda4. La domanda giusta quindi non è “chi è primo?”, ma “quante risposte servono prima che una classifica significhi qualcosa?”.
Uno studio del 2026 firmato da Ron Sielinski (IQRush) affronta esattamente questo punto1. Un esempio, ripreso da un suo lavoro precedente sulla variabilità delle citazioni, rende l’idea. Su un set di domande sull’attrezzatura da corsa poste a SearchGPT (la modalità di ricerca di ChatGPT), Tom’s Guide raccoglieva circa il 9,5% delle citazioni e Runner’s World il 6%: letti sulla dashboard di uno strumento di monitoraggio, i due numeri dicono che il primo è davanti. Ma erano stime costruite su una sola serie di rilevazioni, e i loro margini di errore si sovrapponevano: il distacco poteva essere interamente frutto del caso, e i dati non bastavano a dire quale dei due siti fosse davvero davanti.

La proposta del paper è un criterio per decidere quando fidarsi, da applicare mentre si raccolgono i dati: si ripete più volte la stessa domanda allo stesso motore, ogni volta in una conversazione nuova, si accumulano le risposte e a ogni aggiunta si ricalcola la classifica. Il risultato è affidabile solo quando valgono due condizioni insieme.
- L’ordine ha smesso di cambiare. Con poche risposte raccolte, ogni risposta in più può rimescolare le posizioni: chi era secondo passa primo, chi era quarto sale. Quando la classifica resta uguale anche continuando ad aggiungere risposte, il campione comincia a bastare.
- I distacchi sono più ampi del margine di errore. Ogni percentuale misurata su un campione porta con sé un’incertezza, come nei sondaggi elettorali: se due partiti sono dati al 24% e al 23% con un margine di ±3 punti, non c’è nessun sorpasso, è un pareggio statistico. Il margine non si sceglie, si calcola: dipende dalla percentuale misurata e soprattutto dal numero di risposte raccolte, e si restringe man mano che se ne aggiungono, anche se lentamente (per dimezzarlo serve circa il quadruplo delle risposte). È quello che succedeva a Tom’s Guide e Runner’s World nell’esempio sopra: finché i margini si sovrappongono, l’ordine in classifica non distingue davvero i due siti.
Se manca anche una sola delle due, la classifica non è ancora una misura: è una fotografia mossa. Lo studio non trova una soglia universale: servono comunque decine di risposte, quante esattamente dipende dalla combinazione di motore e argomento, e in qualche caso la classifica non si è stabilizzata affatto. Ogni motore distribuisce le citazioni con logiche proprie, e lo stesso numero di risposte non garantisce la stessa confidenza ovunque. Anche una classifica stabile, infine, è precisa soprattutto in testa: dei primi ci si può fidare, delle posizioni dalla metà classifica in poi non tanto.
Le cautele: è un preprint, non ancora sottoposto a revisione, costruito su domande generate artificialmente. Ma un secondo gruppo, tre ricercatori dell’Università di San Gallo, è arrivato nello stesso periodo alla stessa conclusione su dati propri: una singola lettura non è affidabile, bisogna campionare ripetutamente1.
Per chi compra o vende misurazioni di visibilità AI la conseguenza pratica è un test semplice: un numero presentato senza margine di errore, o un confronto costruito su una lettura sola, è un campanello d’allarme più che una rassicurazione.
Il metodo di rilevazione
Il metodo che uso discende da tutto questo: ogni domanda viene posta più volte a ogni rilevazione, su più motori (ChatGPT, Gemini, Claude, Perplexity, più le AI Overviews di Google, rilevate a parte su un paniere di ricerche), a cadenza regolare. I risultati si aggregano in percentuali di presenza e citazione per motore e in una share of voice complessiva rispetto ai competitor definiti in partenza. Insieme ai numeri registro le condizioni della misura: quali modelli, quante domande, quale versione delle scale di giudizio. Così ogni rilevazione futura è confrontabile, o dichiara esplicitamente di non esserlo.
La prima rilevazione è la baseline: da sola dice già molto (dove sei forte, dove non esisti, chi domina le risposte del tuo settore), ma il suo valore vero emerge nei mesi successivi, quando misura l’effetto degli interventi. E il trend tra una rilevazione e l’altra ha una soglia di rumore dichiarata, sotto la quale una variazione non è una notizia.
Gli errori più comuni
| L’errore | Perché invalida la misura |
|---|---|
| Misurare una volta sola, magari con una domanda | La variabilità documentata sopra rende il dato singolo quasi privo di valore |
| Misurare un solo motore | Ogni sistema recupera e cita con logiche proprie: essere forti su uno non dice nulla sugli altri |
| Contare le menzioni ottenute nominando il brand nella domanda | Gonfiano presenza e share of voice senza misurare niente |
| Non distinguere memoria e ricerca web | Le due condizioni si correggono con leve e tempi diversi: mescolarle rende impossibile ogni diagnosi |
| Ignorare i competitor | La presenza assoluta, senza confronto, non dice se stai vincendo o perdendo |
| Cambiare le domande a ogni giro | Ogni modifica al set azzera la comparabilità con le rilevazioni precedenti |
| Attribuire ogni variazione all’ultimo intervento | Senza più letture prima e dopo, un +3 è indistinguibile dal rumore |
L’altra faccia della misura: il traffico che le AI ti mandano
La visibilità nelle risposte è una faccia della misura; l’altra è il traffico che i motori AI portano al sito, che può essere rilevato con strumenti come Google Analytics.
Nel 2026 i volumi di queste visite sono ancora piccoli in proporzione a quelli relativi ad altri canali, ma la qualità sembrerebbe più alta: per esempio Similarweb, grazie ai suoi dati di clickstream su un panel ampio di siti, ne misura il tasso di conversione intorno al 7%, cioè sopra a quello della ricerca organica5, e Ahrefs e Webflow, misurando il proprio traffico, riportano tassi anche più alti2 (sono aziende con un pubblico che vive di strumenti digitali; nel tuo settore i numeri saranno diversi). La ragione è semplice: chi arriva da una risposta AI ha già ricevuto una raccomandazione e, probabilmente, tende a fidarsi di più.
Rilevare bene questo traffico, però, richiede un minimo di cura. GA4 ha introdotto a maggio 2026 un canale nativo “AI Assistant” che tende a sottostimare il fenomeno: l’elenco delle piattaforme che Google, a oggi, riconosce è incompleto (Perplexity manca e finisce tra i Referral); inoltre lo stesso referrer può spargersi su tre canali diversi (AI Assistant, Referral e Unassigned) perché i browser interni delle app AI spesso non passano il medium5. La soluzione è un gruppo di canali personalizzato che classifica per sorgente, ignorando il medium: riunifica i frammenti, recupera retroattivamente lo storico e include le piattaforme che Google lascia fuori.
Anche così, il numero va dichiarato per quello che è: il traffico delle sorgenti AI identificabili. Le visite dalle app senza referrer finiscono in Direct, e i clic dalle AI Overviews di Google vengono conteggiati come ricerca organica: una parte del fenomeno resta invisibile a qualsiasi canale. È una misura utile e quasi gratuita, ma il suo limite più importante è strutturale: l’analytics parte dal clic. Racconta cosa fanno gli utenti dopo aver cliccato, non quante volte il brand è comparso o è stato raccomandato nelle risposte, ed essere raccomandati a qualcuno che poi non clicca non lascia traccia. La visibilità si misura dall’altra faccia, interrogando i motori come descritto sopra. Con un’eccezione recente, e parziale, che riguarda proprio Google.
Il dato di Search Console: le impression nelle funzioni AI di Google
Il 3 giugno 2026 Google ha annunciato in Search Console i report sul rendimento dell’AI generativa, che isolano le impression raccolte dentro AI Overviews e AI Mode, più le funzioni AI di Discover: quante volte le pagine del sito sono comparse come fonte in quelle risposte, con il dettaglio di pagine (gli URL canonici mostrati), paesi, dispositivi e serie temporali6. Clic, impression complessive e posizioni continuano comunque a confluire nel report di rendimento standard con tipo di ricerca “Web”, come prima: in questo modo le serie storiche vengono mantenute coerenti. Il rollout di questa funzionalità è dichiaratamente graduale: pertanto, se non vedi ancora questo report nella tua Search Console, è normale.
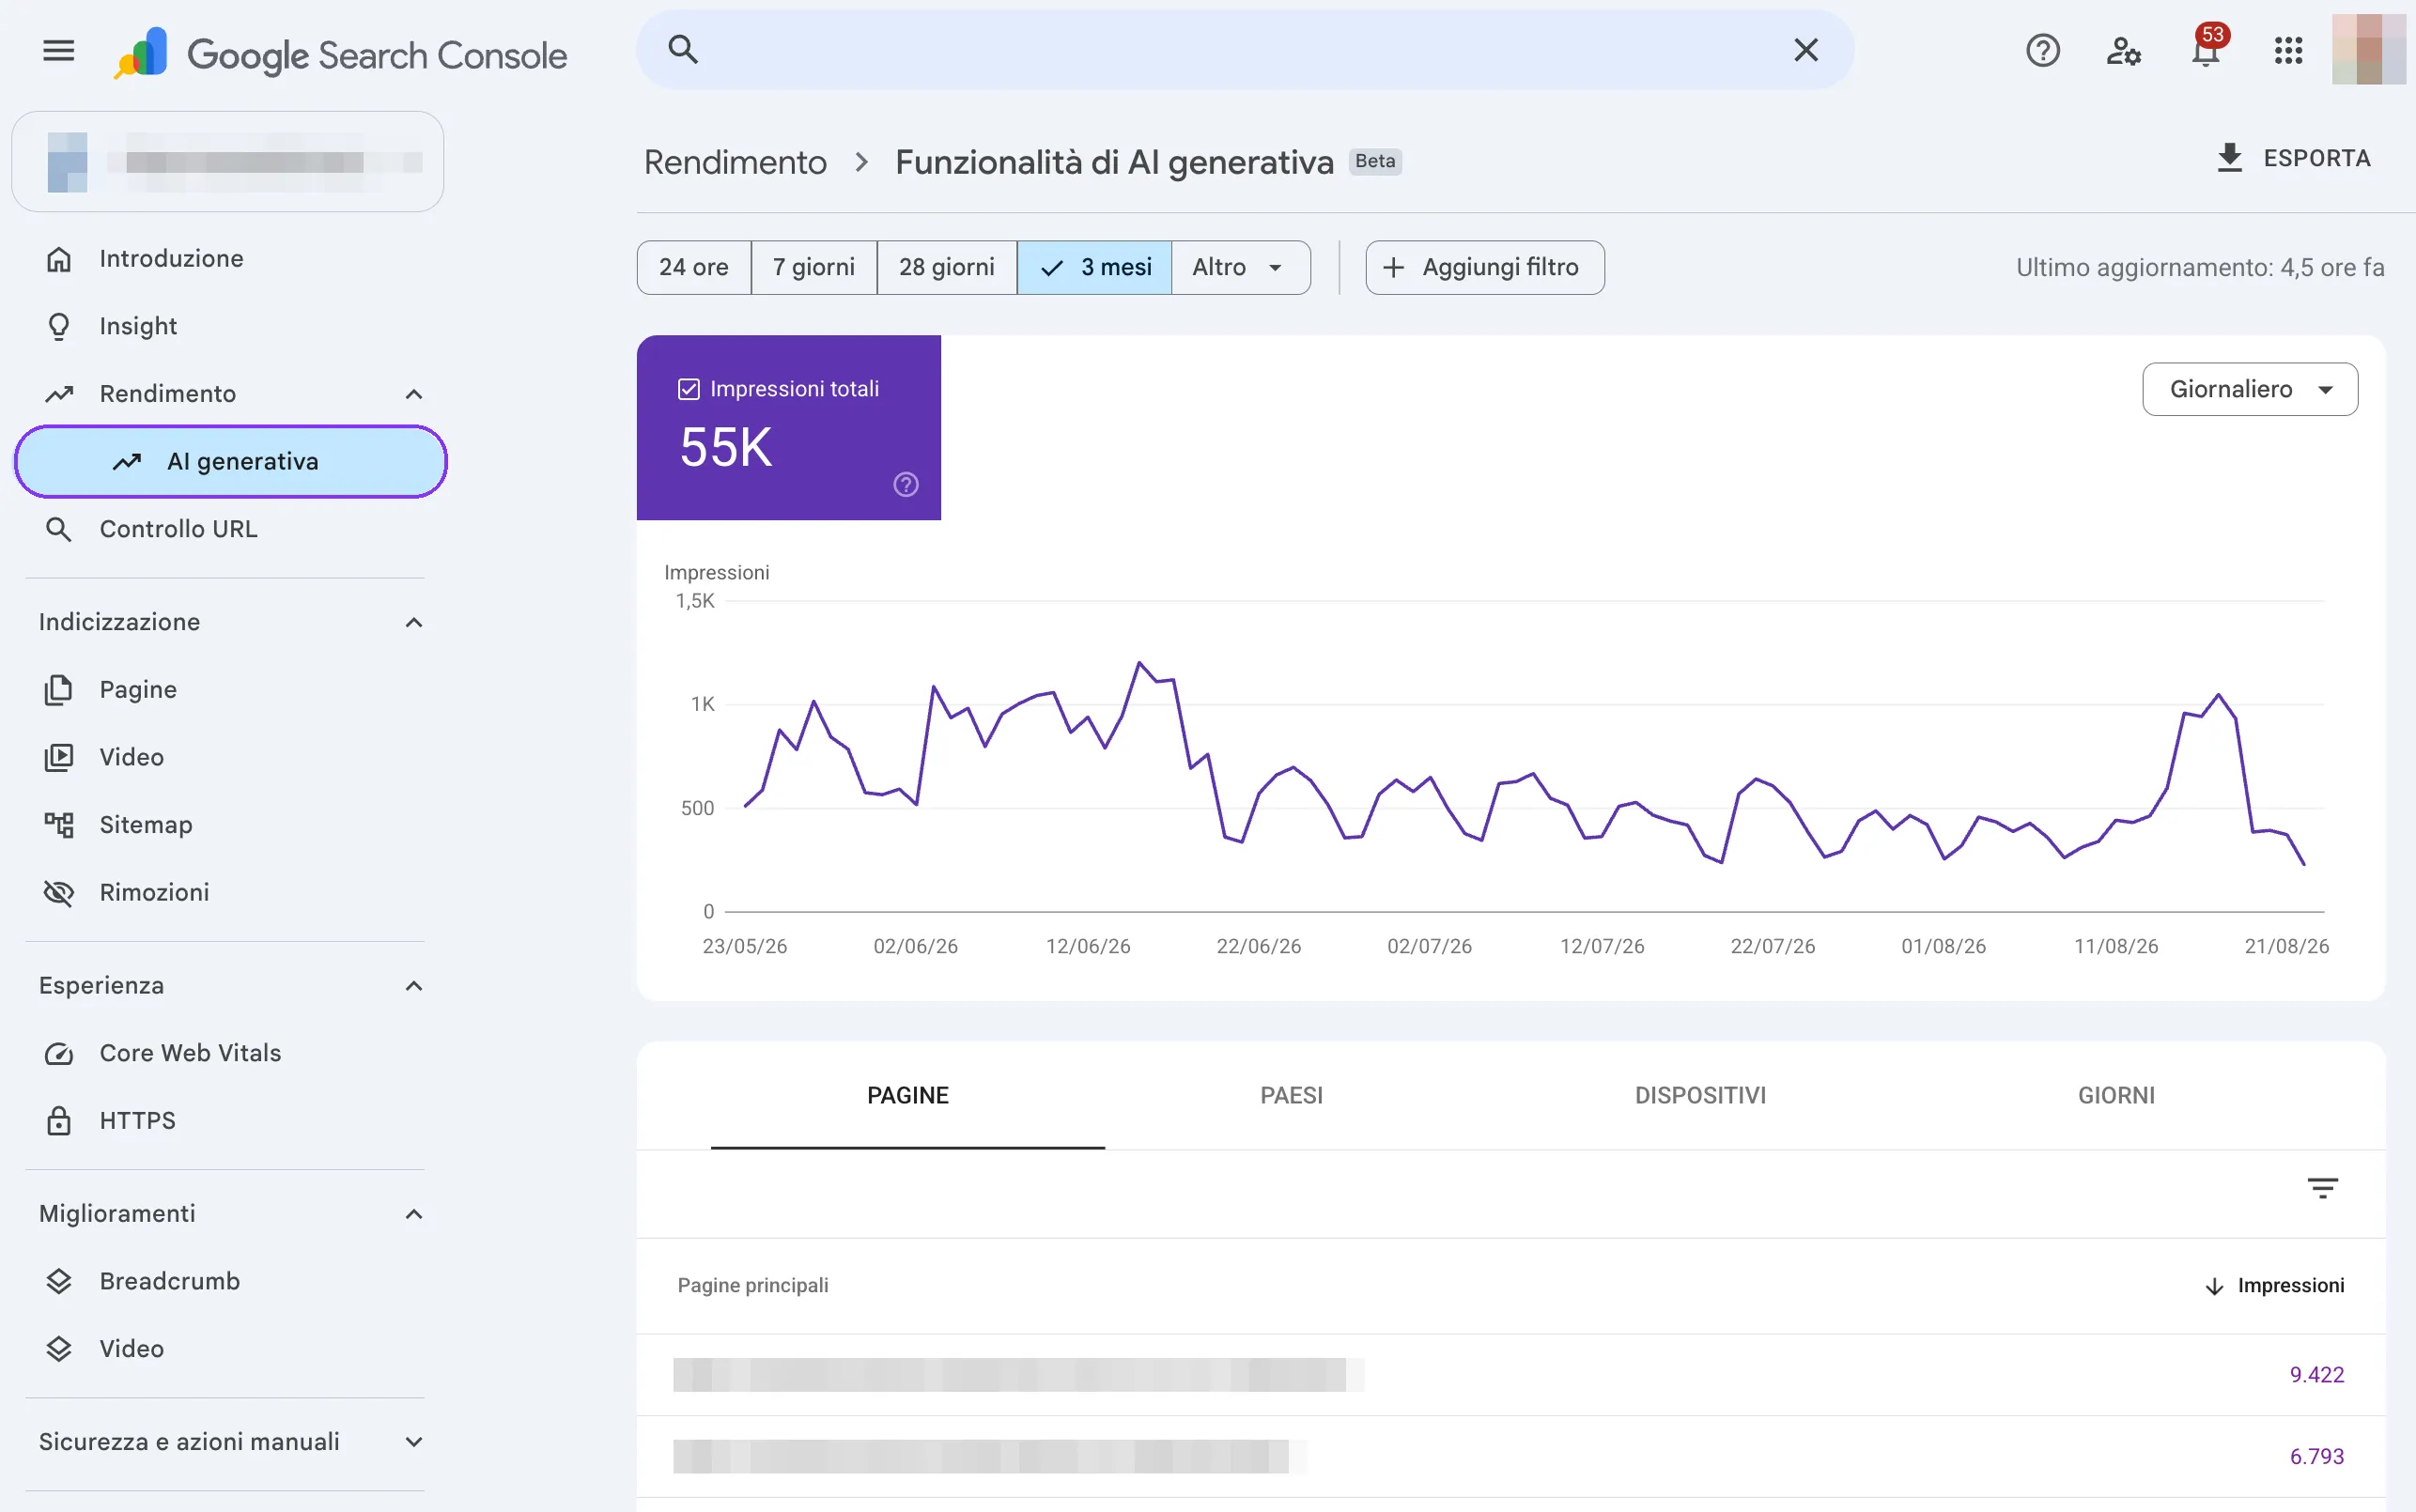
È il primo dato ufficiale sulla visibilità AI: appena il report compare in una proprietà, conviene metterlo tra le letture regolari. Tuttavia, è bene essere consapevoli anche dei limiti: le impression sono aggregate e senza le domande che le hanno generate, non dicono come il brand compare nella risposta, e coprono soltanto le funzioni AI di Google, pertanto resta valida la metodologia fin qui descritta.
Dal numero all’azione
La misura serve solo se orienta il lavoro. Le letture che uso più spesso:
| Cosa emerge dalla misura | Cosa fare |
|---|---|
| I competitor compaiono su domande dove tu non ci sei | Creare o ristrutturare i contenuti su quei temi |
| Le risposte ti nominano senza citare il sito | Rafforzare l’autorevolezza e la citabilità delle pagine |
| Le descrizioni del brand sono sbagliate | Correggere alla fonte: la pagina che alimenta l’errore se nasce dal web, la coerenza delle fonti se nasce dalla memoria dei modelli |
| I motori citano sempre le stesse fonti terze sul tuo mercato | Presidiare quelle pagine: valgono più di una menzione generica |
| Su alcuni temi nessuno domina | Occuparli: è lo spazio più facile da conquistare |
I tempi vanno dichiarati insieme alle azioni: gli interventi sulle fonti web tendono a mostrare effetti nel giro di settimane nelle risposte con ricerca; le correzioni della conoscenza a memoria dei modelli si vedono solo ai cicli di addestramento successivi. Prometterle per il mese prossimo non è corretto.
Se vuoi sapere qual è oggi la tua baseline, scrivimi: la prima rilevazione di presenza, citazioni e share of voice è il punto di partenza di ogni mia consulenza GEO/AEO.
Fonti
-
Ron Sielinski (IQRush), preprint arXiv:2607.10341 (2026), che estende il precedente arXiv:2603.08924 sulla variabilità delle citazioni; ripresi da Matt G. Southern, “AI Visibility Rankings Aren’t Stable – New Research Shows It’s Mostly Statistical Noise”, Search Engine Journal (luglio 2026): searchenginejournal.com. La conclusione sulla necessità di campionare ripetutamente è confermata, su dati indipendenti, da Julius Schulte, Malte Bleeker e Philipp Kaufmann (Università di San Gallo), “Don’t Measure Once: Measuring Visibility in AI Search (GEO)”, arXiv:2604.07585 (2026). ↩ ↩2 ↩3
-
Maja Voje, “AEO: How to Make AI Recommend Your Product”, GTM Strategist (aprile 2026): knowledge.gtmstrategist.com. I dati di conversione di Ahrefs e Webflow sono riportati lì dalle aziende stesse. ↩ ↩2
-
Parametric indica la conoscenza codificata nei parametri (i pesi) del modello durante l’addestramento: la distinzione tra memoria parametrica e non parametrica è formalizzata in Lewis et al., “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks”, arXiv:2005.11401 (2020). Grounding è il termine con cui i fornitori chiamano l’ancoraggio delle risposte alla ricerca in tempo reale: è il nome ufficiale della funzione Grounding with Google Search dell’API Gemini. ↩
-
SparkToro (Rand Fishkin), studio sulla variabilità delle raccomandazioni AI, ripreso da Search Engine Journal, “AI Recommendations Change With Nearly Every Query”: searchenginejournal.com ↩
-
Itamar Blauer, “GA4’s AI Assistant Channel Undercounts Your AI Traffic: How To Build One That Doesn’t”, Search Engine Journal (2026): searchenginejournal.com. Il dato sulla conversione dei referral ChatGPT viene dai dati di clickstream di Similarweb: similarweb.com ↩ ↩2
-
Google Search Central, “Introducing Search Generative AI performance reports in Search Console” (3 giugno 2026): report dedicati per la Ricerca e per Discover con impression, pagine, paesi, dispositivi e serie temporali; il rollout dichiarato è “a un sottoinsieme di siti” per la fase di test: developers.google.com ↩