Dati strutturati: a cosa servono davvero (e a cosa no)
 Di Nicola Burei
Indice dei contenuti
Se ti occupi di un sito, prima o poi i dati strutturati li incontri: sono informazioni in più, inserite nel codice HTML della pagina e invisibili a chi legge, che aiutano i motori a capire di cosa parla una pagina e chi la pubblica. E arrivano quasi sempre insieme a una promessa: migliorano il posizionamento, fanno comparire il sito nelle risposte delle AI.
La realtà è più sfumata: sul posizionamento Google ripete da anni che non incidono, e il legame con le citazioni AI per ora non trova conferme.
I benefici veri sono altri due, l’accesso ai rich results, i risultati arricchiti nelle SERP di Google (le stelline delle recensioni, i prezzi dei prodotti, le date degli eventi in evidenza nella pagina dei risultati), e un’identità più chiara agli occhi dei motori, compresi quelli generativi. Per questo vale comunque la pena occuparsene, è un lavoro di ore più che di mesi: in questo articolo spiego cosa sono, cosa ottieni davvero, cosa non aspettarsi e da dove cominciare.
Cosa sono: schema.org, JSON-LD e chi comanda davvero
I dati strutturati sono un formato standardizzato per descrivere il contenuto di una pagina in un modo che le macchine possano leggere senza doverlo interpretare: un blocco di codice, invisibile a chi naviga, che dichiara per esempio “questa è la pagina di un’azienda, si chiama così, ha sede qui, questo è il suo logo”.
Lo “schema markup” di cui si legge ovunque è un altro nome della stessa cosa, e viene dal vocabolario usato per scriverla: schema.org, il dizionario condiviso che elenca i tipi di cose che si possono descrivere (Organization per un’azienda, Article per un articolo, Product per un prodotto) e, per ciascun tipo, le proprietà da compilare (il nome, la data di pubblicazione, il prezzo).
Una precisazione: schema.org elenca centinaia di tipi di dati strutturati, ma per sapere quali realmente utilizza Google è bene riferirsi alla documentazione di Search Central, non a quella di schema.org. Molti tipi del vocabolario, infatti, non producono alcun effetto nelle SERP di Google1.
I formati supportati sono tre (JSON-LD, Microdata, RDFa) e Google raccomanda il primo1. Il JSON-LD è un blocco a sé nel codice della pagina, separato dall’HTML visibile, ed è per questo il più facile da generare e mantenere. Un esempio minimo, il biglietto da visita di un’azienda:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "Rossi Serramenti",
  "url": "https://www.rossiserramenti.example/",
  "logo": "https://www.rossiserramenti.example/logo.png",
  "sameAs": ["https://www.linkedin.com/company/rossi-serramenti"]
}
</script>
Un dettaglio tecnico da tenere a mente per dopo: Googlebot legge il JSON-LD anche quando viene iniettato nella pagina via JavaScript1. Per i crawler dei motori AI, invece, questa tolleranza non esiste.
Cosa ottieni davvero: i rich results (idoneità, non garanzia)
I dati strutturati servono a due cose documentate: rendono la pagina idonea ai risultati arricchiti di Google, i rich results, e aiutano i motori a capire senza ambiguità di cosa parla la pagina e chi la pubblica.
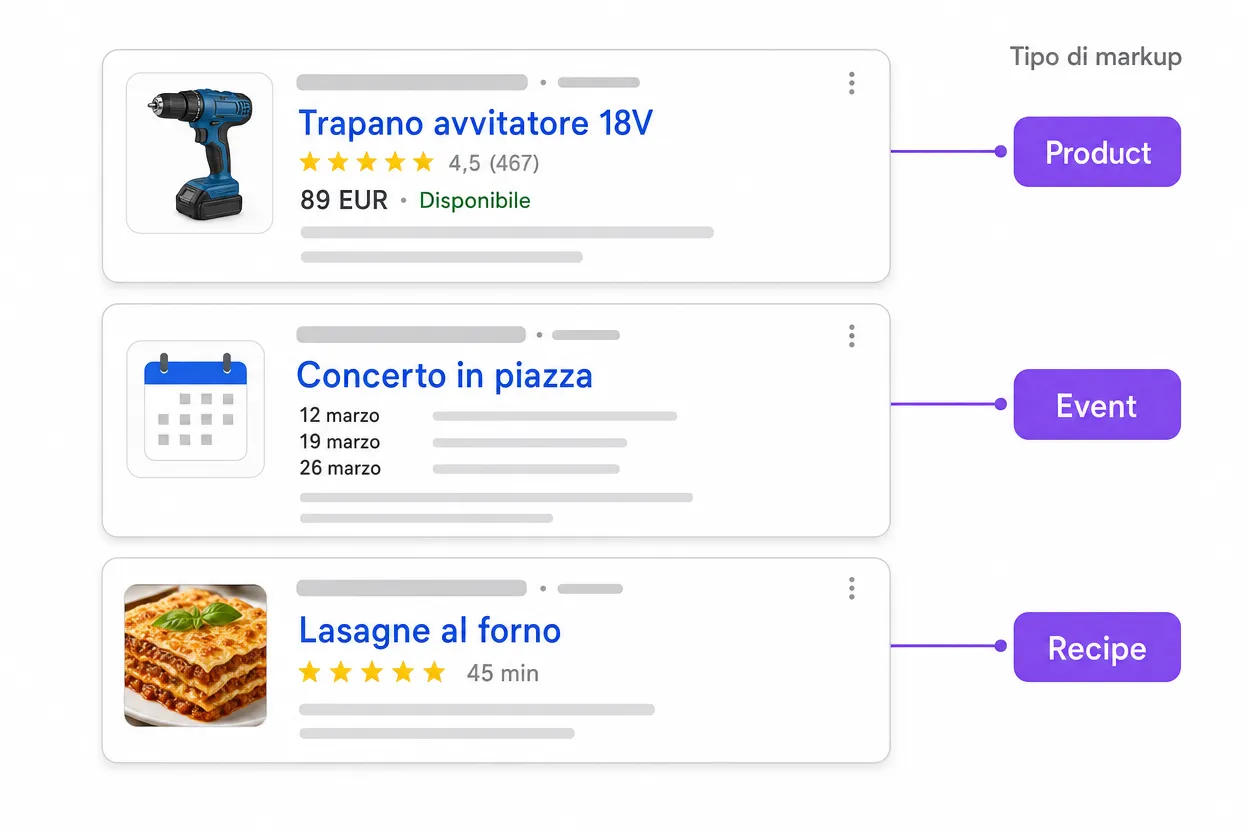
La parola da sottolineare nella documentazione di Google è “eligible”: chi implementa il markup richiesto da una funzione, con tutte le proprietà obbligatorie, diventa idoneo a quella funzione. Idoneo, non titolare di un diritto: la comparsa effettiva la decide Google caso per caso, e un markup perfetto può non produrre nulla di visibile2. Le stelline di recensione sotto un prodotto, il prezzo e la disponibilità, le date di un evento, i tempi di una ricetta: ognuno di questi arricchimenti ha il suo tipo di markup, e il markup è la condizione di accesso, non la garanzia.
Quanto vale un rich result in aumento di clic in SERP? Qui conviene essere onesti sulle evidenze, perché i numeri che circolano vengono quasi tutti da due famiglie di fonti. La prima sono i case study pubblicati da Google nella propria documentazione: Rotten Tomatoes che misura un CTR più alto del 25% sulle pagine con markup, Nestlé che riporta un 82% in più per le pagine che compaiono come rich results. La seconda è uno studio Milestone del 2020 su 4,5 milioni di query, con i rich results al 58% di CTR contro il 41% dei risultati normali3. Sono indizi che il risultato arricchito attiri più clic, non misure su cui basare previsioni precise: i case study sono solo racconti degli interessati, e il 2020 è un’altra era, prima delle AI Overviews e della potatura che sto per raccontare.
Un perimetro che si restringe: cosa Google ha tolto dal 2023 a oggi
L’elenco dei rich results disponibili non è statico, e negli ultimi tre anni si è solo accorciato:
- Agosto 2023: i rich results FAQ vengono ristretti ai “siti governativi e sanitari autorevoli e noti”; per tutti gli altri spariscono. Gli HowTo vengono prima limitati al desktop, poi deprecati del tutto4.
- Giugno 2025: Google elimina sette tipi in un colpo solo (Book Actions, Course Info, Claim Review, Estimated Salary, Learning Video, Special Announcement, Vehicle Listing), dichiarando che erano poco usati. Da settembre quei tipi escono anche da Search Console e dal test dei risultati avanzati4.
- Novembre 2025: seconda ondata. Deprecati i practice problems, precisato che il markup Dataset serve solo a Dataset Search e non alla Ricerca, rimosse alcune funzioni di pagina4.
- Maggio 2026: il rich result FAQ viene ritirato del tutto, anche per i siti governativi e sanitari che ancora lo mostravano. Dal 7 maggio non compare più nelle SERP, e il mese dopo sparisce anche la sua documentazione4.
Da questa cronologia segue un’indicazione pratica: il markup rimasto orfano non danneggia. Google dichiara che i dati strutturati inutilizzati “non causano problemi” e semplicemente non producono effetti visibili4: non serve correre a rimuoverli, serve smettere di aggiungerne per superstizione.
Il beneficio meno visibile: dire alle macchine chi sei
Il secondo beneficio documentato è meno appariscente dei rich results e più duraturo. Google dichiara di usare i dati strutturati non solo per capire la singola pagina, ma per “raccogliere informazioni sul web e sul mondo in generale”: sulle persone, i libri, le aziende citate nel markup1. Un blocco Organization non è una decorazione della SERP: è una voce d’anagrafe che alimenta la conoscenza che il motore ha di te.
La pagina di riferimento è quella del markup Organization, da implementare in home. Aiuta Google a “disambiguare l’organizzazione”: alcune proprietà lavorano dietro le quinte, come la partita IVA, che serve solo a distinguerti dalle aziende con un nome simile; altre controllano elementi visibili, dal logo nei risultati al knowledge panel5. Nessuna proprietà è obbligatoria, e la logica dichiarata è dare tutto ciò che si ha: in particolare i sameAs verso i profili esterni che confermano l’identità, dai social ai registri di settore.
È il beneficio che pesa anche fuori da Google. Un blocco Organization completo è la scheda aziendale machine-readable con cui smentisci alla fonte gli errori che i motori, tradizionali o generativi, fanno su identità, sede e attività. Nella checklist di leggibilità AI i dati strutturati occupano esattamente questo posto: si curano per la chiarezza dell’entità, senza aspettarsi citazioni in cambio del markup.
Cosa non fanno: migliorare il ranking
No, i dati strutturati non sono un fattore di ranking, e Google lo ripete almeno dal 2018. L’occasione più recente è dell’aprile 2025, quando John Mueller ha risposto su Bluesky a chi stava aggiungendo markup “per aiutare la SEO”: “Structured data won’t make your site rank better”, i dati strutturati non faranno posizionare meglio il tuo sito; servono a mostrare le funzioni di ricerca elencate nella documentazione. E, a scanso di equivoci, fuori da quelle funzioni “è improbabile vedere un cambiamento visibile in Google Search”6.
Il dettaglio che trovo più eloquente, però, non è una dichiarazione: è una regola di enforcement. Se Google rileva markup ingannevole e commina un’azione manuale per dati strutturati, la sanzione è la perdita dell’idoneità ai rich results; il posizionamento della pagina nella ricerca web, dice la documentazione, non viene toccato2. Se il markup fosse un ingrediente del ranking, la sua violazione peserebbe sul ranking. Non lo è nemmeno nel momento della punizione.
Dati strutturati e AI: cosa dicono i dati
Resta la seconda promessa, quella che circola di più oggi: i dati strutturati come via per comparire nelle risposte di ChatGPT, Perplexity, Gemini, Claude e Google AI Overviews. Qui il quadro è meno netto e le fonti, a prima vista, dicono cose diverse: vale la pena guardarle una per una.
Una correlazione vera, ma solo una correlazione
Il punto di partenza è un dato reale. Ahrefs ha analizzato 6 milioni di URL e ha trovato che le pagine citate dalle AI hanno il JSON-LD quasi tre volte più spesso di quelle non citate; il 53% delle pagine citate ha markup7. È un dato che si presta a essere citato da solo, ma è solo una correlazione, e la spiegazione più ovvia è che i siti che implementano i dati strutturati sono in genere gli stessi che curano la SEO e, quindi, i contenuti, i link, la manutenzione tecnica e tutto il resto che porta a essere citati. Lo dice Ahrefs stessa: togli lo schema, e con ogni probabilità gli altri segnali portano comunque la pagina alla citazione7.
Lo studio che isola la causa
Per rispondere alla domanda che interessa davvero (“se aggiungo il markup, vengo citato di più?”) serve un esperimento, non una fotografia. Ahrefs ha quindi rintracciato 1.885 pagine che hanno aggiunto JSON-LD tra agosto 2025 e marzo 2026 e le ha confrontate con 4.000 pagine di controllo simili che non l’hanno fatto, verificando l’esito con quattro test statistici concordanti. Risultato: nessun aumento rilevante di citazioni su nessuna piattaforma. Su Google AI Mode +2,4% e su ChatGPT +2,2%, variazioni indistinguibili dal rumore; sulle AI Overviews addirittura un calo del 4,6%, statisticamente significativo ma piccolo, che gli stessi autori non se la sentono di attribuire allo schema7.
Lo studio però copre solo una parte dei casi. Le 1.885 pagine osservate erano tutte già molto citate: significa che i sistemi AI le avevano già trovate, lette e inserite tra le loro fonti, e su quel fronte il markup non aveva più nulla da aggiungere. Il caso opposto resta fuori: una pagina che le AI non citano mai ha il problema di farsi trovare e capire, e lì in teoria il markup potrebbe contribuire. Ahrefs stessa lo riconosce: su queste pagine lo studio non può dire nulla, e un esperimento che misuri questo caso ancora non c’è7.
Chi lo legge davvero (e in quale fase)
Un secondo esperimento completa il quadro dal lato tecnico. searchVIU ha pubblicato una pagina di test con i prezzi di alcuni prodotti fittizi collocati in punti diversi: alcuni nel testo visibile, altri solo nei dati strutturati, e questi ultimi in tutte le varianti (JSON-LD scritto direttamente nell’HTML, JSON-LD iniettato via JavaScript, Microdata e RDFa non visibili in pagina). Poi ha chiesto a ChatGPT, Claude, Gemini, Perplexity e Google AI Mode di elencare prodotti e prezzi. I prezzi nel testo visibile sono stati trovati, con esiti diversi da sistema a sistema; quelli presenti solo nei dati strutturati non li ha trovati nessuno, in nessuna variante: nemmeno il JSON-LD scritto direttamente nell’HTML, cioè implementato nel modo raccomandato8. Quando i sistemi recuperano una pagina per costruire una risposta, leggono quello che leggerebbe una persona.
Il markup iniettato via JavaScript ha poi un problema in più: i principali crawler AI, GPTBot e ClaudeBot in testa, non eseguono JavaScript, quindi un JSON-LD aggiunto lato client (per esempio da un tag manager senza rendering lato server) per loro non esiste in nessuna fase, nemmeno quando raccolgono le pagine per i loro indici8.
E allora perché Microsoft, nel marzo 2025, ha confermato per bocca di Fabrice Canel che Bing usa lo schema markup per aiutare i propri LLM a capire i contenuti9? Perché le fasi sono due, e le evidenze non parlano della stessa. Il recupero in tempo reale, quando il motore va a leggere la pagina per rispondere, ignora il markup: lo dicono i test. L’indicizzazione e l’addestramento, dove il motore costruisce la propria conoscenza del web, possono usarlo: lo dichiara Bing per sé, mentre Google non lo ha mai confermato per AI Overviews e Gemini.
La conclusione che ne traggo: il markup non è la leva delle citazioni AI, e presentarlo così significa scambiare una correlazione per una causa. Resta però il canale con cui consegni, ai sistemi che indicizzano, la versione non ambigua di chi sei e di cosa offri: un motivo sufficiente per farlo bene, nessun motivo per aspettarsi miracoli.
Quali implementare, in che ordine (e gli errori che invalidano tutto)
Se il quadro è questo, la domanda operativa ha una risposta breve. L’ordine che seguo, dal markup che rende di più a quello che rende di meno:
- Organization sulla home: l’anagrafe dell’entità. Nome, indirizzo, logo, partita IVA,
sameAsverso i profili esterni. È il markup che lavora per te su ogni motore, generativi compresi. - Article sui contenuti, con date di pubblicazione e aggiornamento reali. Vale anche come disciplina interna: obbliga a tenere date vere.
- I tipi del tuo settore che abilitano rich results ancora attivi: Product con prezzi e disponibilità per l’e-commerce, Service per chi vende servizi, Course per la formazione.
- FAQPage in coda, con le aspettative giuste: il suo rich result è stato ritirato del tutto nel maggio 2026, e dalle evidenze viste sopra il markup non aiuta né la visibilità nelle risposte AI né la comprensione del testo. Ma inserirlo costa pochissimo e il quadro è in movimento: dove esistono domande e risposte vere, vale la pena metterlo comunque.
Più importante dell’ordine sono le due regole che invalidano tutto. La prima è nelle linee guida di Google: il markup deve dire le stesse cose del testo visibile. L’esempio della documentazione: se il JSON-LD descrive un artista, il corpo della pagina deve descrivere quello stesso artista2. Marcare contenuto invisibile, gonfiato o estraneo alla pagina (le recensioni finte sono il caso da manuale) è la strada per l’azione manuale. La seconda è tecnica e l’ho anticipata: il JSON-LD deve stare nell’HTML che il server consegna, non arrivare dopo via JavaScript. Googlebot perdona, i crawler AI no8: se il tuo markup lo inietta un tag manager, per una parte dei crawler non esiste.
Come verificarli
Due strumenti, entrambi gratuiti. In fase di sviluppo si utilizza il test dei risultati avanzati di Google (“risultati avanzati” è come le pagine di Google in italiano chiamano i rich results), che dice se il markup è valido e per quali funzioni la pagina è idonea. Dopo la pubblicazione basta leggere i rapporti sui risultati avanzati di Search Console, che segnalano gli errori pagina per pagina.
Il criterio per decidere
Ricapitolo. I dati strutturati vanno implementati: costano ore, non mesi, e danno le due cose documentate, cioè l’idoneità ai rich results che restano e un’identità non ambigua agli occhi di chi indicizza, motori tradizionali e generativi. Sul resto conviene guardare le cose come stanno: per quanto abbiamo visto, oggi le aspettative di miglioramenti nel posizionamento o nella visibilità AI sono nulle. Ma il costo di implementazione è molto basso e la situazione è fluida, soprattutto sul fronte AI, dove nessuno sa cosa ci attende nei prossimi anni: la scelta più prudente resta implementarli, senza aspettarsi risultati immediati.
La verifica dei dati strutturati (validità, coerenza col testo visibile, markup che manca dove renderebbe) è tra le prime cose che controllo in un audit SEO, e il lavoro sull’entità è al centro della consulenza GEO/AEO. Se vuoi capire come è messo il tuo sito, scrivimi.
Fonti
-
Google, “Introduction to structured data markup in Google Search”, documentazione Search Central: developers.google.com. Vi si trovano la raccomandazione del formato JSON-LD, la lettura del JSON-LD iniettato via JavaScript, l’avvertenza a fare fede sulla documentazione di Google anziché su schema.org e l’uso del markup per “raccogliere informazioni sul web e sul mondo in generale”. ↩ ↩2 ↩3 ↩4
-
Google, “General structured data guidelines”: developers.google.com. Contiene la regola del contenuto visibile, le linee su completezza e pertinenza e le conseguenze dell’azione manuale per dati strutturati. ↩ ↩2 ↩3
-
I case study di Rotten Tomatoes e Nestlé sono raccolti da Google nella pagina introduttiva citata alla nota 1. Lo studio Milestone del 2020 è riportato da Search Engine Journal (28 settembre 2020): searchenginejournal.com ↩
-
La cronologia delle rimozioni. FAQ e HowTo: Google, “Changes to HowTo and FAQ rich results” (8 agosto 2023): developers.google.com; i sette tipi del 2025: Google, “Simplifying the search results page” (12 giugno 2025, con l’aggiornamento dell’8 settembre sulla rimozione da Search Console): developers.google.com; la seconda ondata: Search Engine Roundtable (6 novembre 2025): seroundtable.com; il ritiro definitivo del rich result FAQ (“This feature will no longer appear in Google Search starting May 7, 2026”) e la successiva rimozione della sua documentazione sono tracciati negli aggiornamenti di maggio e giugno 2026 della documentazione di Search: developers.google.com ↩ ↩2 ↩3 ↩4 ↩5
-
Google, “Organization structured data”: developers.google.com ↩
-
I post di John Mueller su Bluesky riportati da Search Engine Journal (15 aprile 2025): searchenginejournal.com ↩
-
Louise Linehan (analisi dei dati di Xibeijia Guan), “We Tracked 1,885 Pages Adding Schema. AI Citations Barely Moved.”, Ahrefs (maggio 2026): ahrefs.com ↩ ↩2 ↩3 ↩4
-
L’esperimento searchVIU, “Schema Markup and AI in 2025: What ChatGPT, Claude, Perplexity & Gemini Really See” (test dell’ottobre 2025): searchviu.com; sull’incapacità dei crawler AI di eseguire JavaScript, l’analisi di Elie Berreby riportata da Search Engine Journal (20 gennaio 2025): searchenginejournal.com ↩ ↩2 ↩3
-
La conferma di Fabrice Canel a SMX Monaco, riportata da Search Engine Land (20 marzo 2025): searchengineland.com ↩