Estensione per Chrome
SEO Page Anatomy: l'anatomia SEO della pagina che stai guardando
Un'estensione per Chrome che riunisce in un solo report i controlli SEO on-page della pagina aperta: indicizzabilità e segnali che la determinano, title e description, struttura degli heading, elementi nascosti, immagini e link, dati strutturati. L'analisi avviene nel browser: nessun dato viene inviato altrove.
Versione 1.6.0 del 10 settembre 2026 · Chrome per computer · licenza MIT · nessun account, nessuna telemetria
Cos'è
Di estensioni per l'analisi SEO on-page ne esistono molte, e parecchie fanno bene le stesse cose. SEO Page Anatomy non pretende di essere la migliore: raccoglie in un unico posto funzioni che di solito sono distribuite tra più estensioni e le presenta nel modo che preferisco, che è una scelta soggettiva. L'ho costruita con Claude Code, sotto la mia direzione, partendo dai controlli che faccio negli audit, e la uso nel lavoro di consulenza.
Non esprime giudizi sulla pagina. Segnala i punti che possono meritare attenzione e indica da dove viene ogni informazione: sorgente HTML, DOM renderizzato, header HTTP, robots.txt. Stabilire se una segnalazione è un problema spetta a chi conosce il sito e il contesto in cui opera. L'estensione è uno dei tanti strumenti del lavoro di un consulente SEO e non lo sostituisce.
Quattro parti del report, in dettaglio.
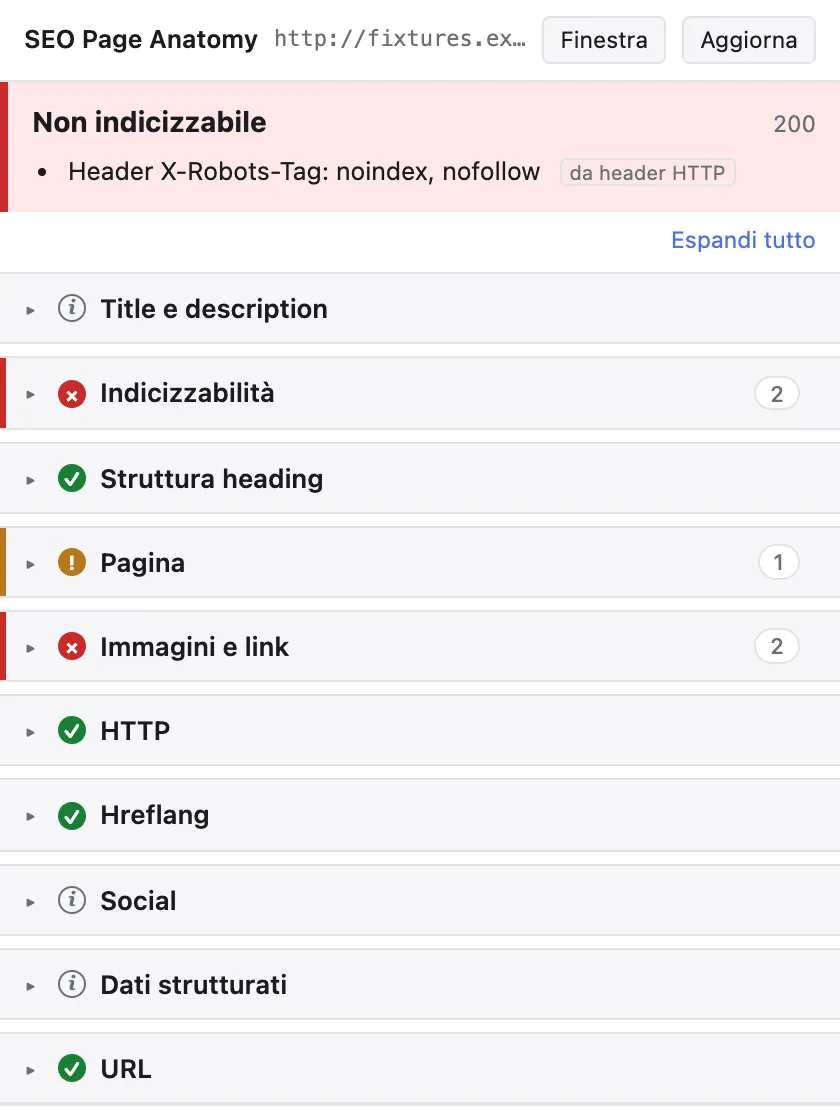
Indicizzabilità. La prima riga dice se la pagina risulta indicizzabile e per quale motivo, combinando status HTTP, robots.txt, header X-Robots-Tag, meta robots e canonical secondo regole di precedenza dichiarate. Gli esiti possibili sono cinque, "Indicizzabile", "Non indicizzabile", "Bloccata da robots.txt", "Canonicalizzata altrove" e "Verdetto non determinabile" quando manca una fonte. Il motivo è sempre indicato, per esempio l'header che contiene il noindex o la riga del robots.txt che blocca l'URL.
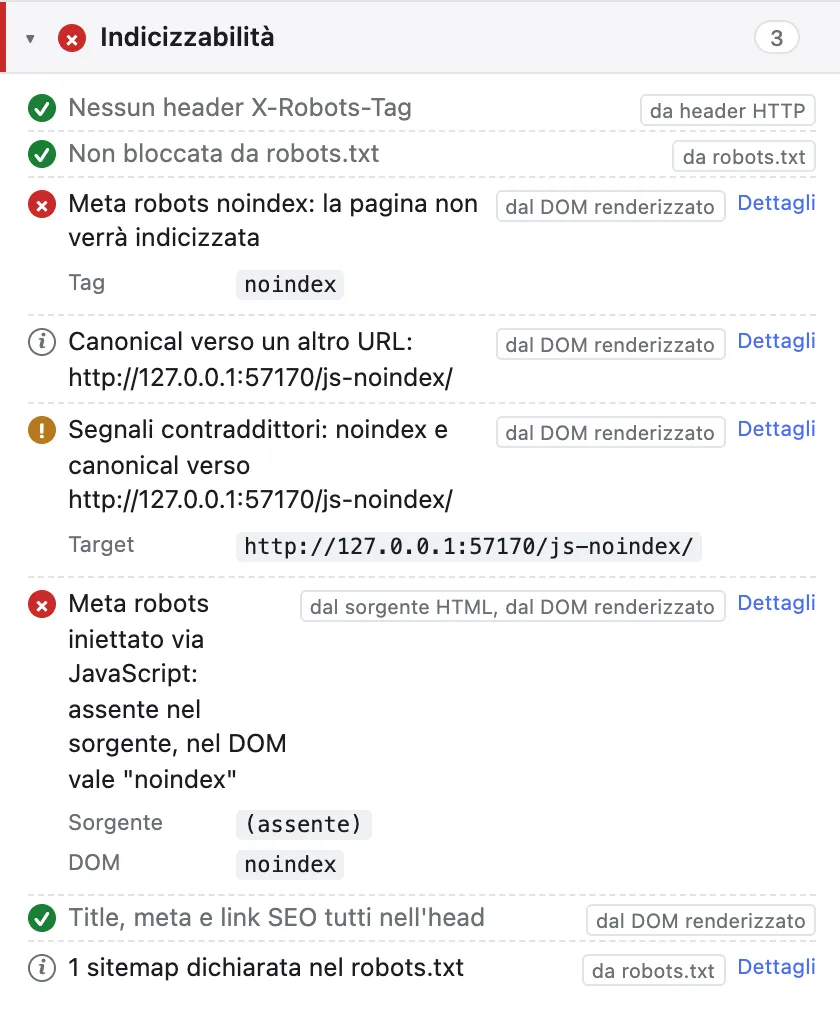
Sorgente HTML e DOM renderizzato. L'estensione legge il sorgente della pagina con una richiesta HTTP e il DOM dopo l'esecuzione di JavaScript, e segnala le differenze su meta robots, canonical, title e tipi JSON-LD con i due valori a confronto e l'indicazione "iniettato via JS" o "rimosso via JS". È il caso di un noindex aggiunto da un plugin o di un canonical riscritto da uno script.
Livello HTTP. Status code, header X-Robots-Tag, canonical e hreflang dichiarati nell'header Link, Content-Type, compressione, meta refresh, possibile soft 404, robots.txt con le sitemap dichiarate.
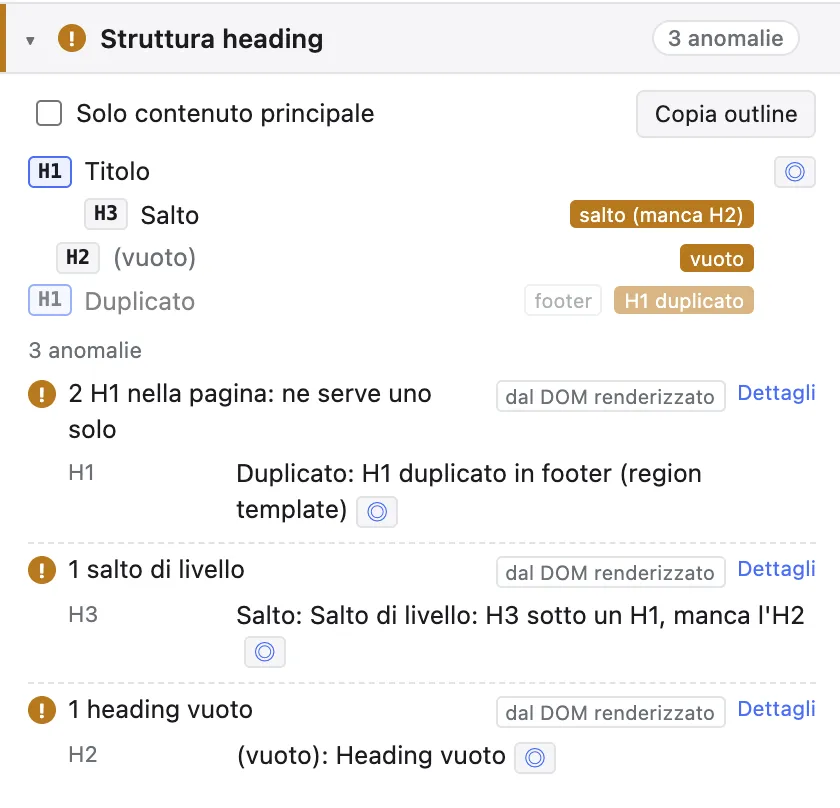
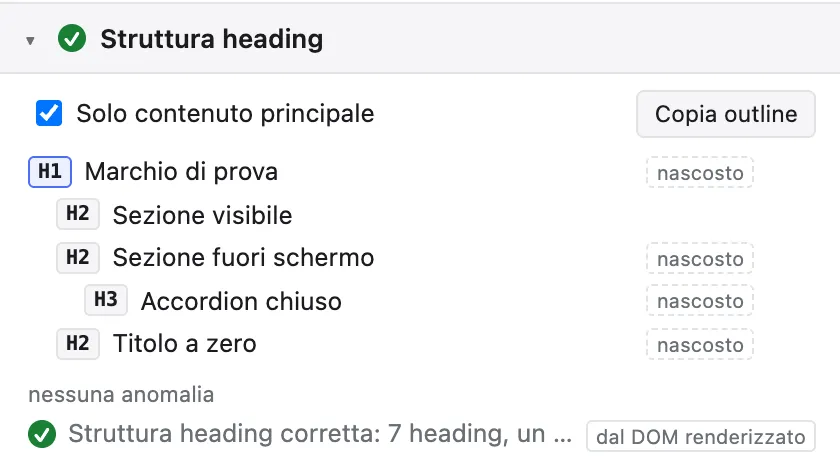
Struttura degli heading. L'albero con i livelli reali, l'anomalia indicata sul titolo che la causa (un H4 sotto un H2, un secondo H1, un heading vuoto), il filtro "Solo contenuto principale" per escludere menu, footer e sidebar, e il tag "nascosto" sui titoli presenti nel DOM ma non visibili nella pagina.
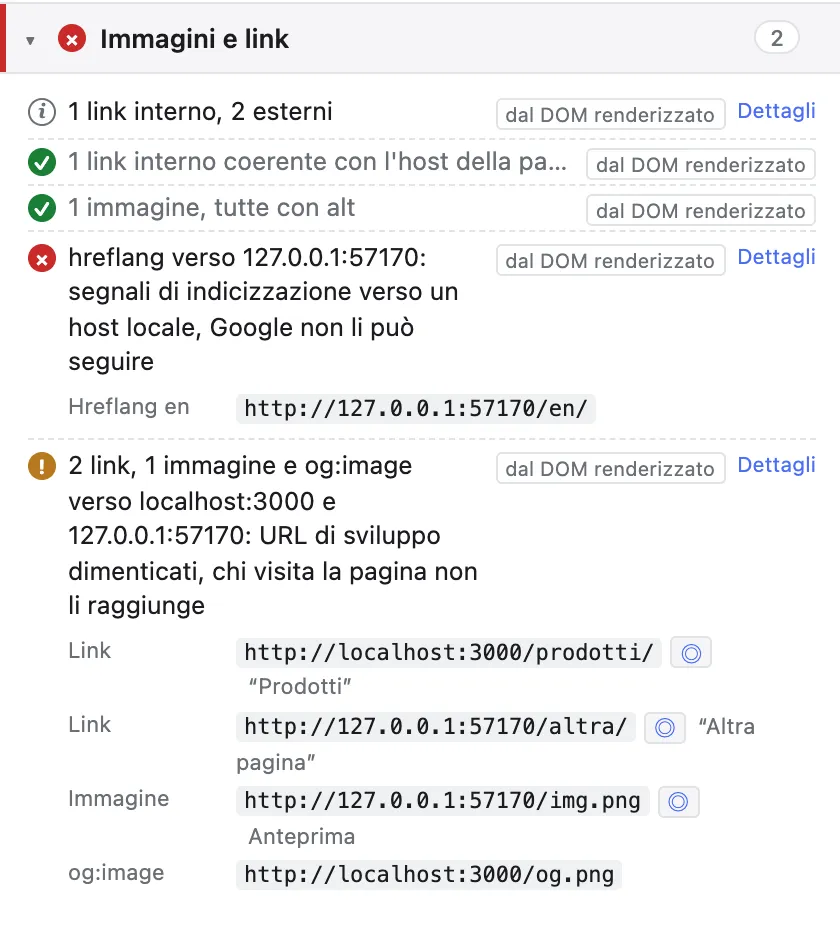
Ci sono poi il bottone "Mostra nella pagina" su ogni heading, immagine o link segnalato (scorre la pagina fino all'elemento e lo evidenzia con un'etichetta), il controllo degli URL di sviluppo rimasti in canonical, link, immagini e meta (localhost, 127.0.0.1, IP privati, domini .local e .test), il rilevamento degli elementi nascosti nel layout (display none, riquadri di 1 pixel, clip, fuori schermo, opacity 0, font-size 0) e l'export del report in markdown o in JSON.
La metto a disposizione così com'è: gratuita, senza registrazione, senza supporto e senza impegno di aggiornamento.
Il report, in pratica
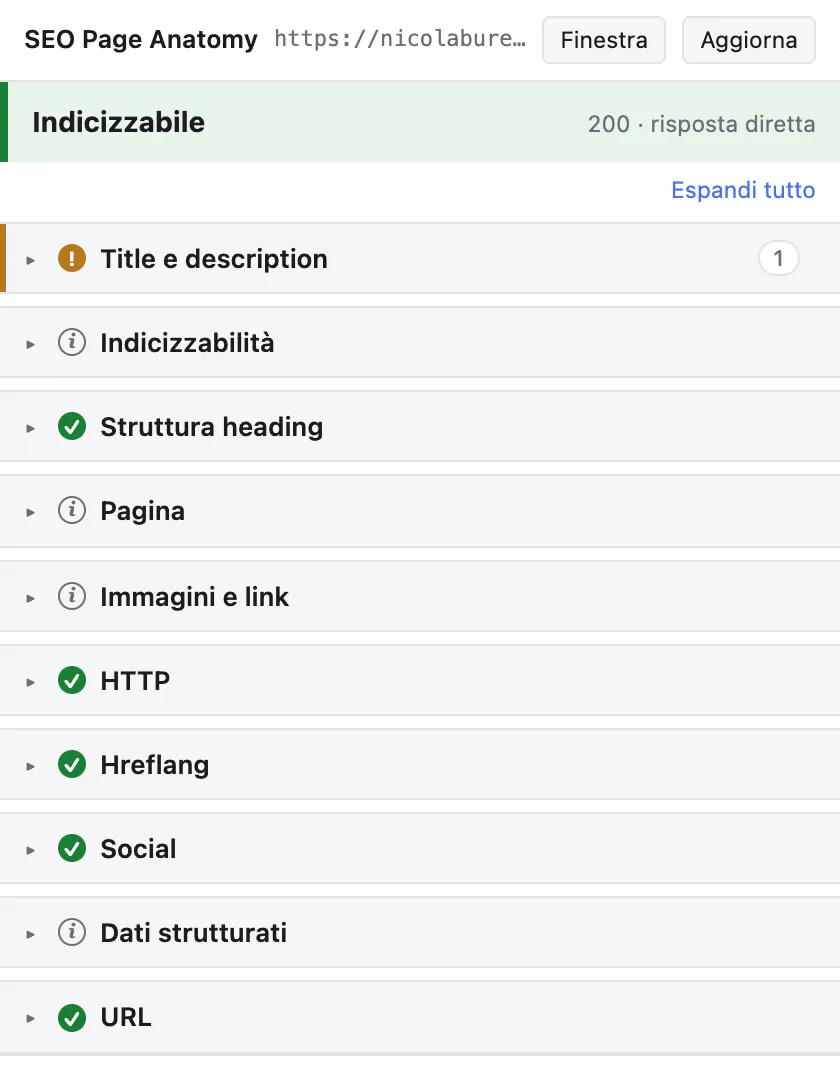
Screenshot della versione 1.6.0 con Chrome impostato in lingua italiana. Il primo è sulla home di questo sito; gli altri su pagine di prova usate nei test dell'estensione, costruite apposta con i problemi da mostrare.
Cosa controlla
Il report ha 43 controlli in 10 sezioni. Ogni controllo ha una gravità: ok, nota (un fatto da sapere, non un problema), attenzione, critico. Per ogni esito diverso da ok il report dice cosa ha trovato e, quando serve, cosa fare; i controlli ok restano visibili in forma compatta, così si vede anche cosa è a posto. La gravità è un'indicazione di partenza: quanto pesi davvero un punto dipende dal sito e dal contesto.
| Sezione del report | Cosa verifica |
|---|---|
| Title e description | Presenza, unicità, larghezza in pixel come in SERP (barra con contatore, soglie 580 px per il title e 920 px per la description), title identico all'H1. |
| Indicizzabilità | Meta robots con tutte le direttive (anche max-snippet, noarchive, unavailable_after); blocco da robots.txt con la riga che scatta e lo user-agent; conflitto tra robots.txt e noindex ("Google non vedrà mai il noindex"); canonical presente, self o verso altro URL, assoluto o relativo, canonical multipli discordanti; canonical verso la stessa pagina con http/https o www diversi (residuo di migrazione); noindex più canonical altrove (segnali contraddittori); confronto sorgente/DOM su meta robots, canonical, title e JSON-LD; head interrotto (meta, canonical o hreflang finiti nel body); sitemap dichiarate nel robots.txt; rilevamento di pagine SPA. |
| Struttura heading | Albero completo con livelli, H1 assente o multiplo, salti di livello, heading vuoti, primo heading non H1, heading da immagine (alt) o da ruolo ARIA, heading nascosti nel layout, filtro "Solo contenuto principale", bottone "Copia outline" (ogni riga porta il livello, per esempio "- H2: Titolo sezione"). |
| Pagina | Attributo lang, meta viewport, base href, conteggio parole (contenuto principale e pagina intera, con le parole nei blocchi nascosti contate a parte), elementi nascosti: heading, link, immagini e testo che Google legge nel DOM ma non sono visibili nel layout attuale, con il motivo. |
| Immagini e link | Conteggio link interni ed esterni con nofollow, sponsored e ugc; link interni verso http da pagina https, verso la versione non canonica dell'host, con parametri di tracciamento, senza destinazione, senza testo, con nofollow, con ancore generiche ("clicca qui", "leggi tutto"); immagini senza alt, in http su pagina https, senza width e height, prima immagine del contenuto con lazy loading; URL di sviluppo dimenticati (localhost, 127.0.0.1, IP privati, .local, .test) in canonical, hreflang, link, immagini, meta social, favicon e base href. |
| HTTP | Status code finale, redirect seguiti dal browser prima della pagina, header X-Robots-Tag, canonical e hreflang nell'header Link (e conflitto con l'HTML), Content-Type e charset, compressione assente su risposte oltre 20 KB, meta refresh, possibile soft 404 (title o H1 da pagina di errore con status 200). |
| Hreflang | x-default e auto-riferimento, validità dei codici (it-IT sì, it_IT no: Google lo ignora in silenzio), hreflang su pagina con canonical altrove, href relativi. |
| Social | Set Open Graph (title, description, image, url, type) completo o no, og:url coerente col canonical, og:image relativo, Twitter card o fallback OG, favicon dichiarata. |
| Dati strutturati | Sintassi di ogni blocco JSON-LD con posizione dell'errore, inventario dei @type presenti, blocchi senza @context, presenza di Microdata o RDFa. |
| URL | Parametri in query, maiuscole nel path, lunghezza oltre 200 caratteri, coerenza dello slash finale col canonical. |
Come si usa
Apri la pagina da analizzare e clicca l'icona di SEO Page Anatomy, oppure premi Alt+Maiusc+I. Il popup mostra l'esito di indicizzabilità e le sezioni, tutte chiuse: l'intestazione di ogni sezione ha l'icona di gravità e il conteggio dei problemi, un clic apre solo quella che interessa. Il bottone "Finestra" stacca il report in una finestra separata che resta aperta mentre lavori sulla pagina. "Aggiorna" rianalizza ignorando la cache della sessione.
L'interfaccia e i messaggi sono in italiano se Chrome è in italiano, in inglese in ogni altro caso: nessuna impostazione da fare.
Tre esportazioni. "Copia report" mette negli appunti il report in markdown: esito di indicizzabilità, controlli non ok con i messaggi, outline degli heading. "Copia outline" copia solo la struttura degli heading, con il livello davanti a ogni riga. "Copia JSON" copia il report strutturato, con formato dichiarato (seo-page-anatomy/report, versione 1), per script, fogli di calcolo e agenti.
Ogni heading dell'albero e ogni immagine o link elencato nei dettagli ha il bottone "Mostra nella pagina": la pagina scorre fino all'elemento, che viene evidenziato con un'etichetta finché non premi Esc. Funziona anche se chiudi il popup.
Privacy e permessi
L'estensione chiede tre permessi: activeTab, scripting, storage. Nessun permesso sui siti: fino al clic sull'icona non vede nessuna pagina e non ha alcuno script attivo nei siti che visiti. Al clic, e solo per quella scheda, inietta lo script che legge il DOM e fa una richiesta HTTP alla pagina stessa e al suo robots.txt, dal tuo stesso browser.
Nessun dato lascia il browser. Non ci sono server, account, telemetria, statistiche d'uso, né codice scaricato da remoto. Lo storage serve a tre cose: ricordare le preferenze di visualizzazione (le sezioni aperte), tenere in memoria il report della sessione per non rianalizzare la stessa pagina a ogni apertura, e conservare le soglie configurabili. Nessun dato di analisi viene salvato in modo persistente.
Cosa non fa
Sono scelte o vincoli reali: meglio saperli prima di installare.
- Una pagina alla volta. Niente crawling, niente confronto tra pagine, niente storico delle analisi.
- Chrome per computer. Niente Firefox, Safari, smartphone.
- Installazione in modalità sviluppatore. L'estensione non è sul Chrome Web Store. Chrome mostra un avviso all'avvio, e l'estensione non si aggiorna da sola: ogni versione nuova si scarica e si sostituisce a mano.
- Siti con protezione anti-bot. Se il server rifiuta la richiesta del sorgente o non risponde entro il tempo massimo, il report lo dice con un banner e prosegue con il solo DOM renderizzato: intestazioni HTTP e confronto sorgente/DOM non sono disponibili in quel caso.
- Catena di redirect. Con i permessi minimi l'estensione vede quanti redirect il browser ha seguito prima della pagina, non gli URL intermedi. Il messaggio lo dichiara e rimanda a curl o a un crawler per la catena completa.
- Larghezze in pixel approssimate. Il calcolo usa Arial 20 px per il title e 14 px per la description, con soglie 580 e 920 px: approssimazioni di come Google mostra i risultati, che cambiano nel tempo.
- Elementi nascosti: una fotografia della finestra. Un sito responsive visto da desktop ha il menu mobile in display none, tab e accordion chiusi: sono nascosti legittimamente e il report li segnala come nota, riservando l'attenzione all'H1 del contenuto nascosto e al testo nascosto oltre la metà del totale.
- Pagine molto grandi. L'estrazione si ferma a 500 heading, 2000 link, 500 immagini e 50 blocchi JSON-LD, e in quel caso il report dice cosa ha saltato. I frame interni non vengono analizzati.
- Pagine non analizzabili. Pagine interne di Chrome, file locali, store del browser, PDF: il popup mostra un messaggio, non un report.
Non verifica i link rotti, la reciprocità degli hreflang, lo stato HTTP del canonical né la presenza dell'URL nella sitemap; non valida i campi richiesti per ogni tipo JSON-LD e non confronta desktop e mobile.
Download, installazione e aggiornamenti
Funziona su Chrome per computer. L'estensione non è sul Chrome Web Store: si installa in modalità sviluppatore, bastano due minuti.
-
Scarica lo zip
File seo-page-anatomy-chrome.zip, 85 KB, versione 1.6.0.
-
Estrai lo zip
Su Mac basta un doppio clic. Su Windows fai clic con il tasto destro e scegli Estrai tutto: il doppio clic apre lo zip senza estrarlo, e da lì Chrome non può caricare nulla. Ottieni la cartella seo-page-anatomy-chrome. Spostala in una posizione stabile, per esempio in Documenti: Chrome caricherà l'estensione da questa cartella, quindi non va cancellata né spostata dopo l'installazione.
-
Apri la pagina delle estensioni
In Chrome vai all'indirizzo chrome://extensions.
-
Attiva la modalità sviluppatore
L'interruttore Modalità sviluppatore è in alto a destra.
-
Carica la cartella
Clicca Carica estensione non pacchettizzata e seleziona la cartella seo-page-anatomy-chrome, quella che contiene il file manifest.json.
-
Fissa l'icona
L'estensione compare nell'elenco. Clicca l'icona a puzzle nella barra di Chrome e fissa SEO Page Anatomy con la puntina, così resta sempre visibile.
-
Facoltativo: attivala anche in incognito
Nelle finestre di navigazione in incognito Chrome tiene spente le estensioni, salvo autorizzazione. Se vuoi analizzare una pagina senza cookie e senza sessioni aperte, in chrome://extensions clicca Dettagli sulla scheda di SEO Page Anatomy e attiva Consenti modalità Incognito. Chrome mostra un avviso uguale per tutte le estensioni, sulla possibilità di registrare la cronologia: SEO Page Anatomy non registra né invia nulla, anche in incognito.
Al prossimo avvio Chrome può mostrare un avviso sulle estensioni in modalità sviluppatore: è normale per le estensioni installate fuori dallo store, basta chiuderlo.
Aggiornare
L'estensione non si aggiorna da sola. Quando esce una versione nuova:
- Scarica di nuovo lo zip dallo stesso link ed estrailo.
- Sostituisci il contenuto della cartella seo-page-anatomy-chrome con i file nuovi, stessa cartella e stessa posizione di prima: se la cambi, Chrome perde l'estensione e va rifatta l'installazione.
- In chrome://extensions clicca Ricarica sulla scheda di SEO Page Anatomy.
La versione installata è indicata sulla scheda dell'estensione in chrome://extensions.
Disinstallare
In chrome://extensions clicca Rimuovi sulla scheda di SEO Page Anatomy. Dopo la rimozione puoi cancellare anche la cartella seo-page-anatomy-chrome.
Licenza e responsabilità
SEO Page Anatomy è distribuita con licenza MIT: puoi usarla liberamente, anche nel lavoro per i tuoi clienti. È fornita così com'è, senza garanzie: i controlli aiutano a vedere, le conclusioni restano tue. Non offro supporto e gli aggiornamenti non sono garantiti. Il testo della licenza è nel file LICENSE dentro lo zip.
Domande frequenti su SEO Page Anatomy
Perché non è sul Chrome Web Store?
È una risorsa che metto a disposizione, senza l'impegno di manutenzione che uno store richiede. Si distribuisce solo da questa pagina e si installa in modalità sviluppatore, in due minuti. Pubblicare sul Chrome Web Store richiederebbe la dichiarazione da operatore commerciale prevista dal Digital Services Act, con i recapiti esposti sulla scheda, e ogni aggiornamento passerebbe da una revisione.
Chrome mostra un avviso sulle estensioni in modalità sviluppatore: è un problema?
No. Chrome lo mostra all'avvio per qualsiasi estensione installata fuori dallo store, e basta chiuderlo. Non dice nulla sul contenuto dell'estensione: i permessi richiesti sono tre (activeTab, scripting, storage), nessuno sui siti visitati, e nessun dato lascia il browser.
Cosa succede sui siti protetti da Cloudflare o da altri sistemi anti-bot?
Se il server rifiuta la richiesta del sorgente o non risponde entro il tempo massimo, il report lo dice con un banner e prosegue con il solo DOM renderizzato. In quel caso mancano le intestazioni HTTP e il confronto sorgente/DOM; tutto il resto del report resta disponibile.
Che differenza c'è tra "nota" e "attenzione"?
Una nota è un fatto da sapere, non un problema: per esempio un canonical che punta a un altro URL, o un menu mobile nascosto su desktop. Attenzione segnala qualcosa che di norma va sistemato, come un H1 mancante o un link interno verso http da una pagina https. Critico è riservato a ciò che impedisce l'indicizzazione o la contraddice, come un noindex insieme a un canonical verso un altro URL.